
InstantNGP 的加速来自编码方式与工程实现的共同改进。在 NeRF 场景中,可以从三个方面理解:
- 使用更小的 MLP,并通过融合 CUDA kernel 降低网络计算开销。
- 结合 ray marching 和占据网格,跳过空区域中的无效采样。
- 使用可训练的多分辨率哈希编码,降低网络学习空间细节的难度。
这篇笔记主要梳理第三点,并给出相关实现入口。
NeRF 为什么需要位置编码
原始 NeRF 根据空间位置 和观察方向 ,预测体密度 与颜色 ,再通过体渲染得到像素颜色。这里预测的是密度,并非直接输出 alpha;alpha 还与采样间隔有关。
如果直接把坐标输入 MLP,网络往往更容易学习低频变化,较难拟合高频细节。NeRF 因此先用一组不同频率的正弦、余弦函数对输入进行编码。对单个坐标分量 ,记频率数为 :
这相当于一个 的映射。对各坐标分量分别编码后再拼接,就能向网络提供不同频率的输入特征,缓解其对低频的偏好。
多分辨率哈希编码
与固定的三角函数编码不同,InstantNGP 把空间坐标映射到一组可训练的网格特征。这些特征与后续网络一起优化。
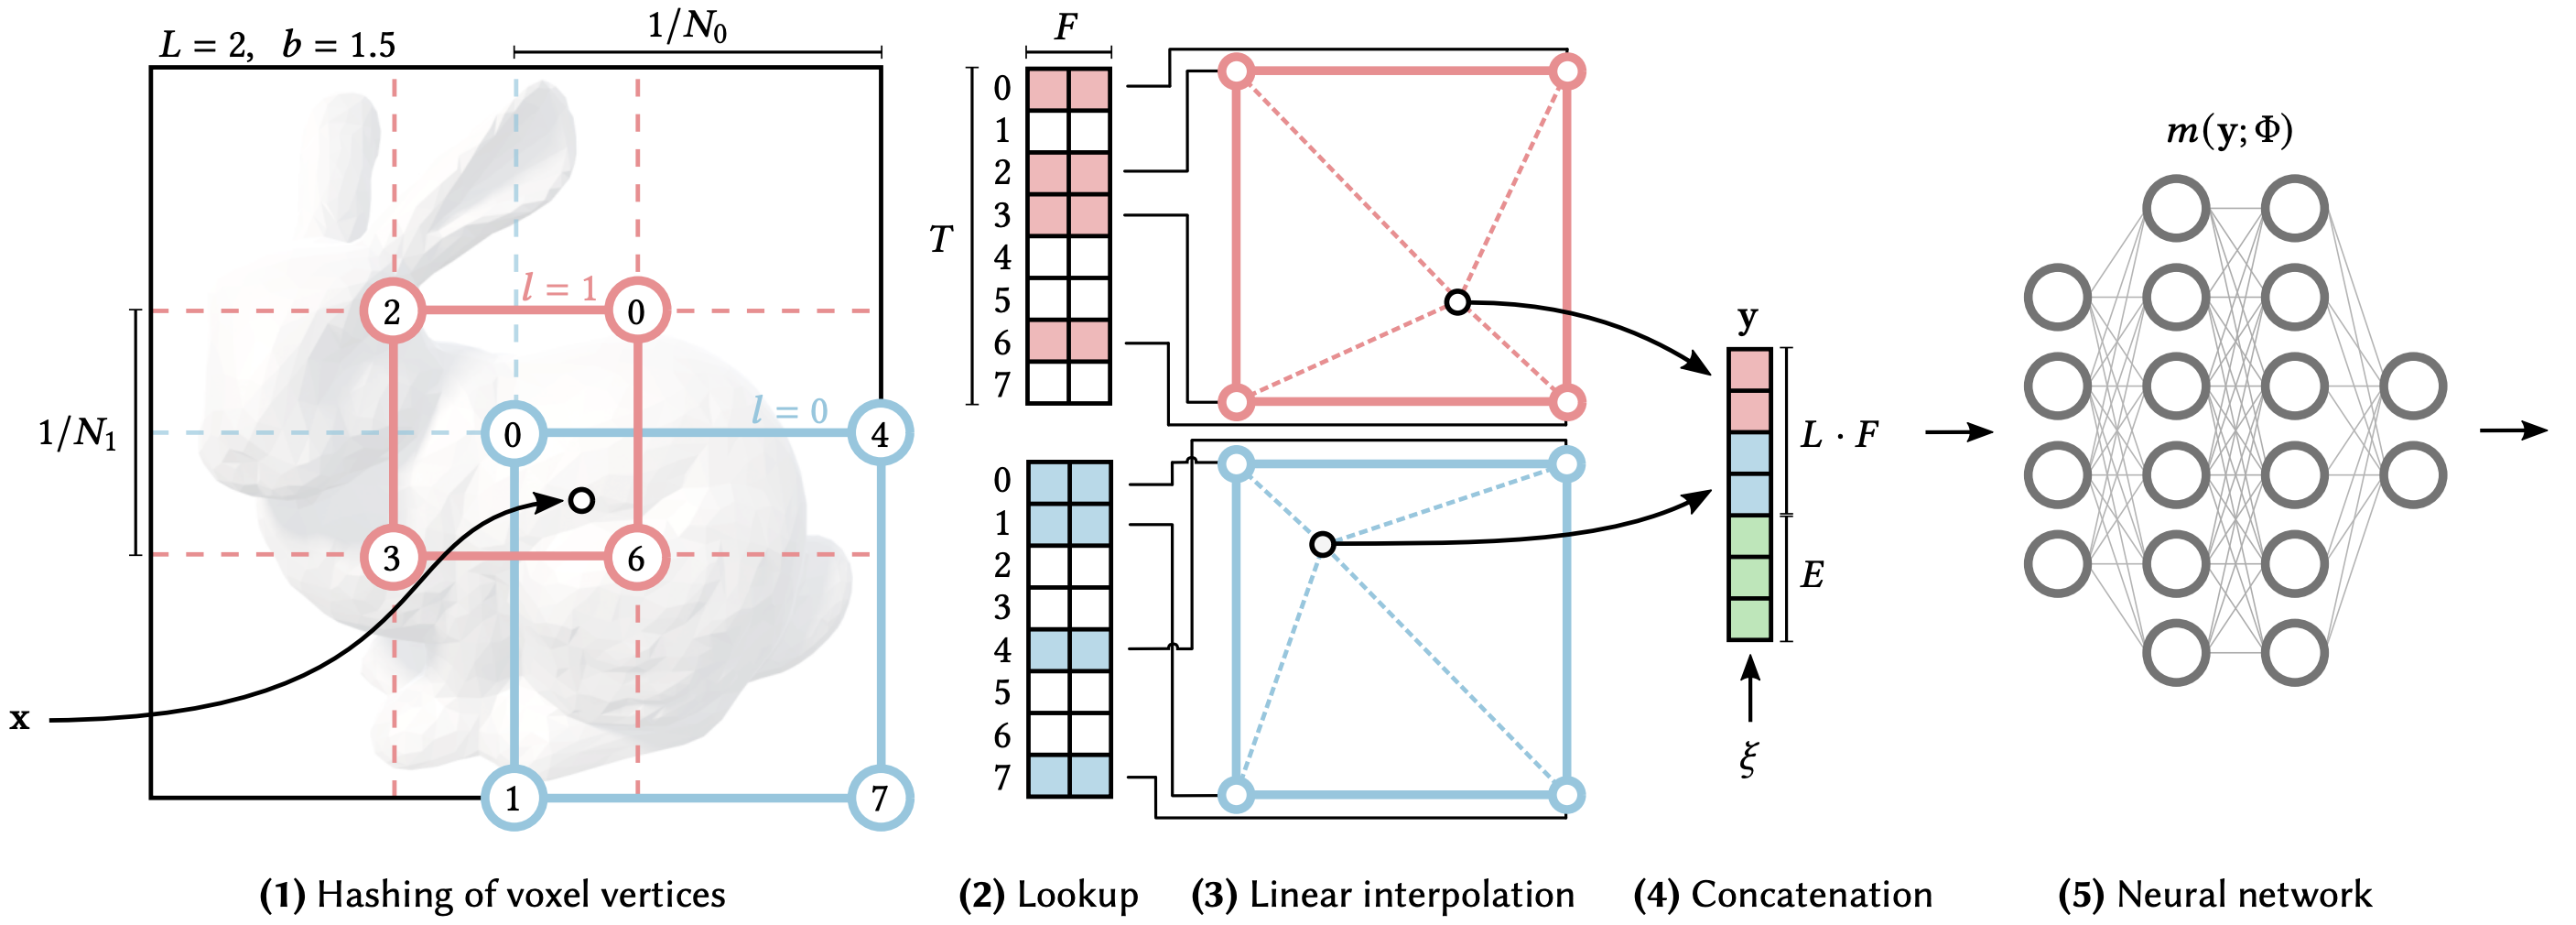
设编码包含 个分辨率层级,每个网格顶点对应一个 维特征向量。对给定位置 ,编码过程如下:
- 定位网格。 在某个分辨率层级中,找到包围 的网格单元。三维情况下,一个单元有 8 个顶点。
- 查询特征。 根据顶点的整数坐标计算索引,查出各顶点的特征向量。低分辨率层可以直接索引;顶点数超过表容量时,通过哈希限制存储规模。
- 插值。 根据 在网格单元内的位置,对 8 个顶点的特征做三线性插值,得到该层的 维特征。
- 拼接。 对全部 层重复上述过程,再把各层结果拼接,得到 维编码。
之后,编码结果被送入小型 MLP;在 NeRF 中,还会结合方向等信息预测密度与颜色。
粗分辨率网格表达较大尺度的变化,细分辨率网格补充局部细节。哈希会让不同顶点共享同一表项,也就是发生碰撞;多分辨率并不会消除碰撞,而是让网络可以结合其他层的信息区分位置。
实现入口
InstantNGP 的官方实现使用 C++ 和 CUDA,并依赖 tiny-cuda-nn。理解编码本身时,可以从 nerfstudio 的 HashEncoding 入手:它提供 PyTorch 实现,也支持调用 tiny-cuda-nn 后端。
阅读时可以重点看三处:各层分辨率如何生成、顶点索引如何计算,以及插值结果如何拼接。输入始终是三维坐标,输出维度则是 num_levels * features_per_level。
不同编码的可视化对比见 nerfstudio 的 Field Encoders 文档。