
训练神经网络可以先看作一个数值问题:给定输入和正确答案,选择一组参数,让模型的预测尽量接近答案。参数如何影响预测、误差如何反过来影响参数,是整个训练过程的两条主线。
以房屋面积预测价格为例,最简单的模型是 。数据提供 和真实价格 ,模型提供当前预测 ,训练要调整的是 和 。语言模型的参数和数据复杂得多,但同样需要表示输入、计算预测、衡量误差,再更新参数。我们从这条完整流程开始。
为什么先学会用数组思考
如果有一百万个样本,逐个用 Python 循环计算 ,解释器就需要反复处理取值、类型和函数调用。NumPy、PyTorch 等数值库把大量同类数据放在数组或张量中,再把运算交给优化过的底层实现。
import numpy as np

x = np.array([1.0, 2.0, 3.0])
w, b = 2.0, 1.0
prediction = x * w + b
print(prediction)  # [3. 5. 7.]
这里的乘法和加法一次描述整批数据的处理过程,这就是向量化。它并不意味着没有循环,而是循环和并行调度被移到了更适合执行数值计算的层次。将数据放到 GPU 后,大量彼此独立的计算还可以同时执行。
张量形状表达数据的组织方式
标量、向量、矩阵都是张量。真正需要记住的是每一维的含义:一批图片常用 (B,C,H,W),一批文本的隐藏表示常用 (B,T,D),分别表示批大小、序列长度和特征维度。
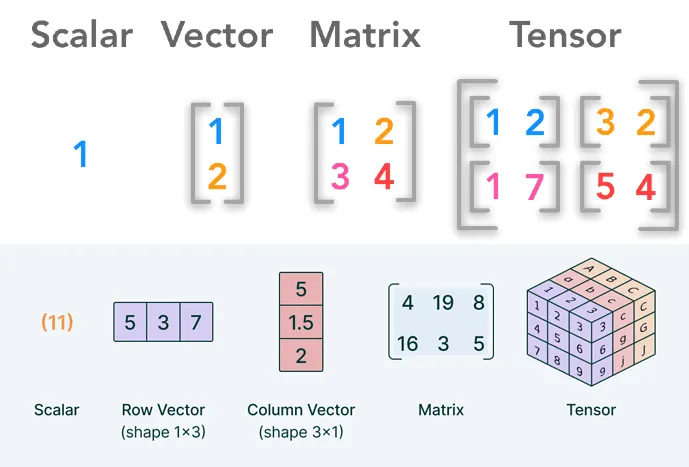
假设有 32 个样本,每个样本包含 10 个特征。输入 的形状是 (32,10)。若想为每个样本生成 4 个输出,可以使用权重 和偏置 :
矩阵乘法完成特征组合;加偏置时,形状 (4,) 的 会被广播到每一行。广播从尾部维度开始对齐,两个维度相等或其中一个为 1 时,才可以扩展。因此 (32,4)+(4,) 合法,而 (32,4)+(32,) 通常不合法;若要给每个样本加一个数,应将后者变成 (32,1)。
逐元素乘法 * 与矩阵乘法 @ 也要分开。前者让对应位置相乘,后者包含沿公共维度的乘积求和。检查形状能发现许多错误,但形状相同仍不代表语义相同,例如不能把 batch 维误当成时间维。
形状、内存与设备是三个问题
reshape 改变数据的分组方式,transpose 交换维度;它们不一定复制底层存储。转置后得到的张量可能是非连续视图,view 对布局有要求,而 reshape 可以在必要时复制数据。
import torch

x = torch.arange(24).reshape(2, 3, 4)
y = x.transpose(1, 2)
print(y.shape)            # torch.Size([2, 4, 3])
print(y.is_contiguous())  # False
z = y.reshape(2, 12)
张量还带有 dtype 和 device。Token ID 通常是整数,参与学习的权重通常是浮点数;模型参数和输入要放在兼容的设备上。把一个张量移到 CUDA,并不会自动移动所有其他张量。理解这些属性,比看到错误后不断添加 reshape 或 .cuda() 更可靠。
用损失函数衡量预测误差
回到 。对一批 个样本,可以使用均方误差:
损失是一个标量,数值越小表示这批预测越接近目标。它对参数的导数给出局部变化方向:
沿梯度反方向走一小步,就得到梯度下降:。学习率 控制步长。步长过大可能越过低损失区域,过小则更新缓慢。对深层网络手工推导每个参数的梯度很繁琐,因此需要自动微分。
计算图怎样完成反向传播
考虑 、。当 时,前向计算得到 、。反向传播按照链式法则组合局部导数:
import torch

x = torch.tensor(3.0, requires_grad=True)
y = (x + 2) ** 2
y.backward()
print(x.grad)  # tensor(10.)
PyTorch 在前向过程中记录求导所需的运算和中间值。backward() 沿这张图计算梯度,结果保存在叶子张量的 .grad 中。它只计算梯度;修改参数是优化器的工作。多个分支共享参数时,来自各条路径的梯度会相加。
这也解释了为什么默认需要清空梯度:连续调用反向传播会累积 .grad。梯度累积可以有意用来模拟更大的 batch,但一次独立更新前不清零,会把前一次更新用过的梯度再次混入。
一次完整的训练循环
下面拟合 ,可在安装 PyTorch 后直接运行。nn.Linear(1,1) 保存可学习的权重与偏置,优化器拿到这些参数的引用后负责更新。
import torch
from torch import nn

torch.manual_seed(0)
x = torch.linspace(-1, 1, 64).unsqueeze(1)
y = 2 * x + 1
model = nn.Linear(1, 1)
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

for step in range(200):
    optimizer.zero_grad(set_to_none=True)
    prediction = model(x)
    loss = nn.functional.mse_loss(prediction, y)
    loss.backward()
    optimizer.step()

with torch.no_grad():
    print(model(torch.tensor([[0.0], [1.0]])))
循环中的顺序有明确的因果关系:先用当前参数预测,计算损失,再求梯度,最后更新参数。下一轮的预测才会反映这次学习的结果。
数据较多时,通常每次处理一个 mini-batch。完整遍历训练集一次称为一个 epoch;一次优化器更新通常称为一个 step。使用梯度累积时,一个 step 可以处理多个 micro-batch,损失的缩放也要与预期的平均方式一致。
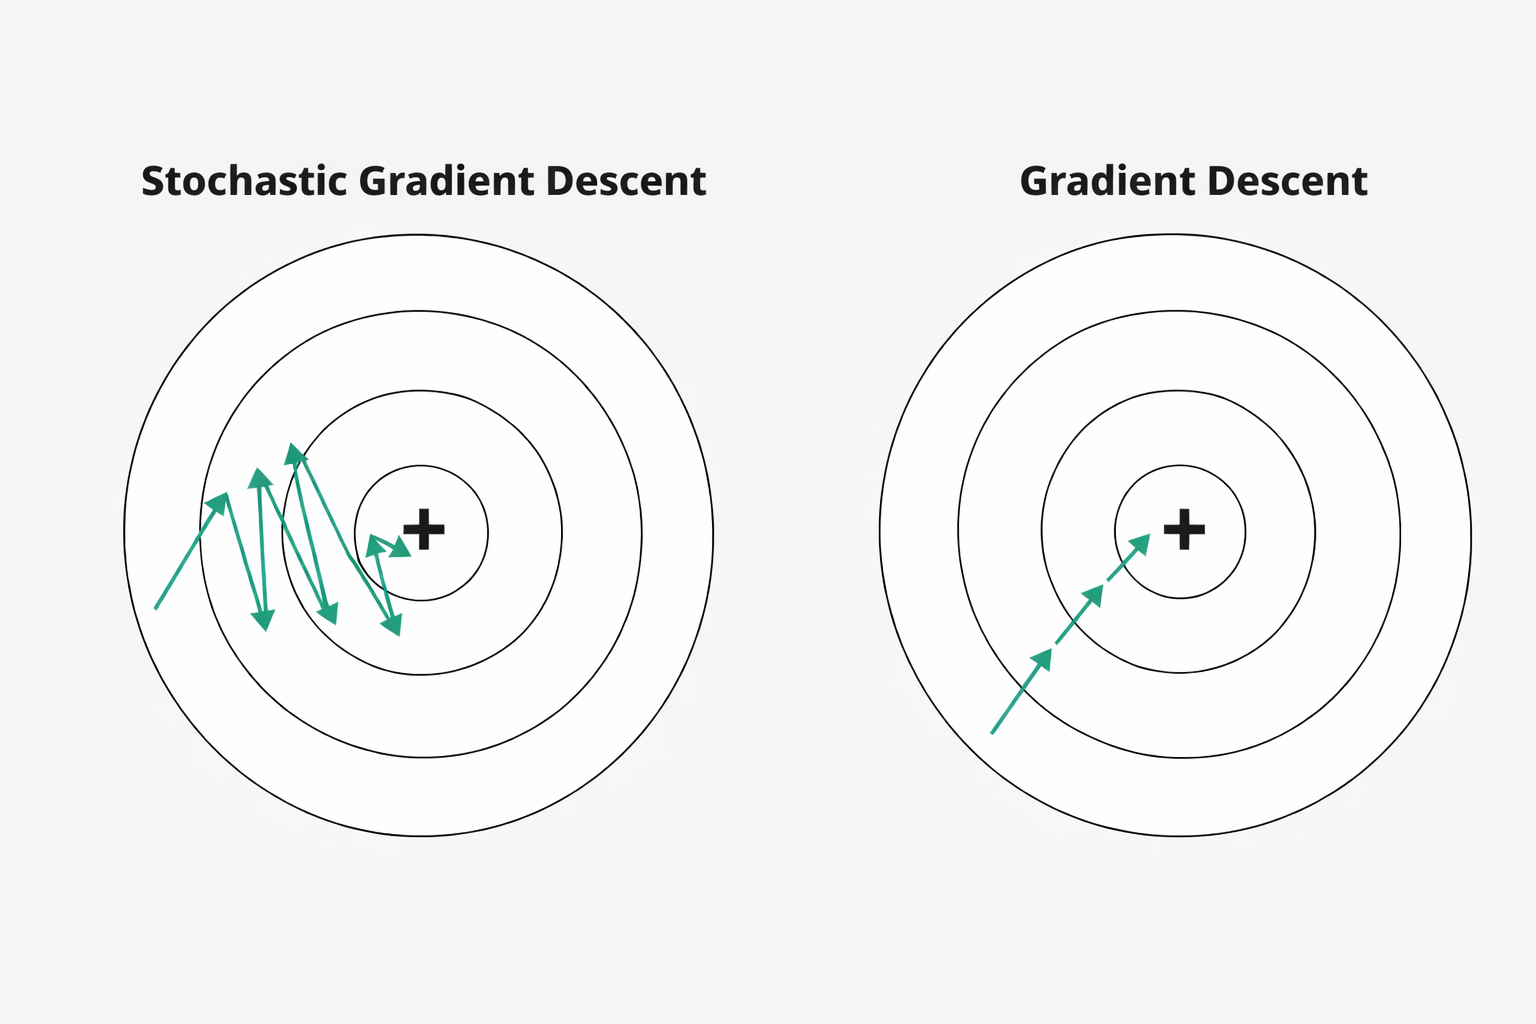
图中随机梯度的方向波动较大,因为每次只用部分数据估计总体梯度。全批量梯度更平稳,但每次更新要读取全部训练数据。Mini-batch 在更新成本、并行效率与梯度方差之间取折中。
从线性模型走向神经网络
把线性层堆叠起来还不够:两个连续线性变换仍能合并成一个线性变换。加入 ReLU、tanh 等非线性激活后,网络才能表示更复杂的关系。例如 Linear → ReLU → Linear 可以先形成中间特征,再将特征组合成输出。nn.Module 用来组织这些层,nn.Sequential 适合按固定顺序连接它们。
训练后还需要在没有参与更新的数据上评估。训练损失下降只说明模型更适合训练样本,不直接说明它能处理新输入。保存模型时可以保存 state_dict(),同时记录网络结构、数据处理方式与训练配置,才能正确恢复模型。
推理模式与梯度记录分别控制什么
model.train() 与 model.eval() 控制 Dropout、BatchNorm 等模块的行为。eval() 不会关闭自动微分;推理时通常还使用 torch.no_grad() 或 torch.inference_mode() 减少求导开销。
detach() 则将某个张量从当前求导路径中分离,适合日志记录或明确需要停止梯度的分支。若在模型中间错误地调用它,前面一段参数就无法从后续损失获得梯度。理解“数据如何流动”和“梯度如何返回”,是阅读训练代码时最有用的两条检查线索。
自动微分接口的细节可查阅 PyTorch Autograd 教程。