
输入一句“今天的天气”,模型为什么能接着写“很好”?中间至少发生了四件事:文字被切成 token,token 被转换为向量,网络根据上下文输出候选分数,再由解码策略选出一个 token。选出的结果重新成为输入,生成过程才得以继续。
先把这条数据流讲清楚,就可以把 tokenizer、神经网络和解码算法各自负责的工作分开理解。
从 one-hot 到可学习的向量
计算机可以给词表中的每个元素分配一个整数 ID,但编号本身不表达语义。ID 为 100 不比 ID 为 10 更重要,两个编号相近也不表示它们含义相似。
One-hot 向量是一种直接表示:若词表大小为 ,就使用长度为 的向量,仅对应位置为 1,其余位置为 0。它方便区分身份,却很稀疏;不同 one-hot 向量彼此正交,也没有表达语义接近程度。
Embedding 引入可学习矩阵 。ID 为 的 token 对应第 行向量,维度从 降为可选择的 。从数学上看,one-hot 向量与 相乘也是取这一行;实现中直接查表即可。
import torch
from torch import nn

embedding = nn.Embedding(5000, 128)
ids = torch.tensor([[12, 38, 7], [21, 12, 9]])
x = embedding(ids)
print(x.shape)  # torch.Size([2, 3, 128])
Embedding 的参数通过训练更新。某些训练目标会使语义或句法关系相近的词呈现相似的几何关系:
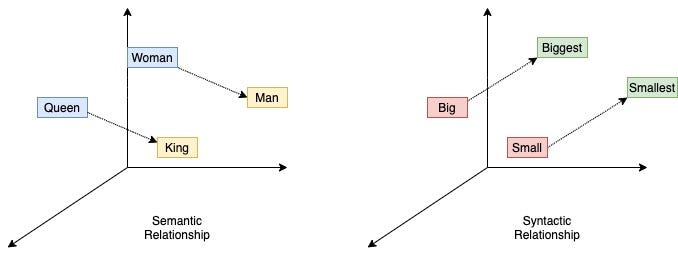
图展示的是向量关系的直观解释。语言模型的初始 embedding 仍然只由 ID 决定;后续网络把上下文混入表示后,同一个 token 在不同句子里才会拥有不同的隐藏状态。
Tokenizer 决定模型看到哪些单位
按单词切分容易产生很大的词表,遇到新词还需要处理未知项;按字符切分词表较小,却会拉长序列。子词方法允许常见片段整体编码,较少见的词则由多个片段构成。
BPE 的基本思路是从较小单位开始,反复合并训练语料中经常相邻的单位,形成一个固定词表。比如可以用 un + believ + able 解释子词组合,但实际 tokenizer 未必如此切分 unbelievable。空格、大小写、字节表示和训练语料都会影响结果。
Tokenizer 训练完成后,编码过程按确定规则把文本转换为 ID 序列;它不需要在每次输入时重新学习词表。模型权重与 tokenizer 必须配套,否则同一个 ID 可能被解释为完全不同的元素。
BOS、EOS、PAD 等特殊 token 用来表达开始、结束或补齐。它们的 ID 和使用方式属于模型约定,不是所有模型都采用相同的文本标记。
为什么批处理需要 padding
两句话分别有 3 个和 5 个 token,不能直接放进一个规则的二维张量。常见做法是将短句补到相同长度,并用 attention mask 标记哪些位置是真实输入:
input_ids:      [ 12, 38,  7, PAD, PAD ]
attention_mask:[  1,  1,  1,   0,   0 ]
Padding 解决存储形状问题,mask 解决计算语义问题。把 PAD 的 embedding 设成零,也不代表所有网络层都会自动忽略它;位置编码、偏置或递归更新仍可能引入影响。训练损失还需要单独排除补齐的目标位置。
自回归模型另外使用 causal mask,阻止当前位置读取未来答案。Padding mask 排除不存在的内容,causal mask 限制允许使用的时间范围,二者可以同时存在。
从隐藏向量到下一 token 的概率
设网络输出隐藏状态 。输出线性层把最后一维映射到词表大小 ,得到 logits,形状为 (B,T,V)。每个位置都有一组词表分数。
Logits 可以为任意实数。Softmax 将它们变成非负且总和为 1 的概率:
减去最大值不会改变比例,却可以避免直接计算过大的指数。例如 logits 为 [2,1,3] 时,概率约为 [0.245,0.090,0.665]。训练时常用的交叉熵函数内部会处理相应运算,因此通常直接传入 logits。
下一 token 预测怎样形成训练样本
自回归模型将序列概率分解为条件概率的乘积:
例如 token 序列是 [BOS, 我, 喜欢, 猫, EOS],可以将输入与目标错开一位:
input:  [BOS, 我,   喜欢, 猫]
target: [我,   喜欢, 猫,   EOS]
训练时真实前缀已知,模型在每个位置学习预测下一个真实 token。这种使用真实历史输入的方式称为 teacher forcing。损失是各有效位置负对数概率的平均或求和。若模型给正确答案的概率很小,损失就大;训练会调整参数,使正确目标在相应上下文下更可能出现。
生成时没有未来真实 token 可用,因此每一步必须把自己选出的 token 追加到输入,再计算下一步。这是训练与生成在数据流上的关键差别。
Greedy 为什么可能错过更好的整段序列
Greedy 每一步选择当前概率最大的 token,简单且没有采样随机性。但它只比较当前一步,不保证整段序列的联合概率最大。
假设第一步有 A、B 两条路径,概率分别为 0.6 和 0.4。A 路径后续两步的最优概率都是 0.4,整段概率为 ;B 路径后续两步分别为 0.8 和 0.9,整段概率为 0.288。Greedy 在第一步选中 A 后,就不会再考虑 B。
Beam search 每步保留多个候选前缀。若 beam width 为 ,就把这些前缀的下一步扩展放在一起,根据累计对数概率选出新的 条。对数把乘积变成求和,也避免长序列概率下溢。实际还要处理 EOS 和长度偏好:直接比较概率乘积往往偏向更短的序列,因此实现可能使用长度归一化。
保留更多候选增加了计算和存储成本。更高的序列概率也不必然对应开放式对话中更有用的回答,所以生成聊天文本时经常使用采样。
温度与候选截断怎样配合
采样按概率随机选择 token。温度 在 softmax 前缩放 logits:
较低温度让高分项更突出,较高温度让分布更平坦。这改变的是选择分布,不是模型记忆中的事实。Greedy 可以单独实现,不应在这条公式里直接除以零。
Top-k 保留固定数量的高概率候选;top-p 将候选按概率降序排列,保留累计概率达到阈值的最小前缀。随后都要重新归一化,再进行采样。
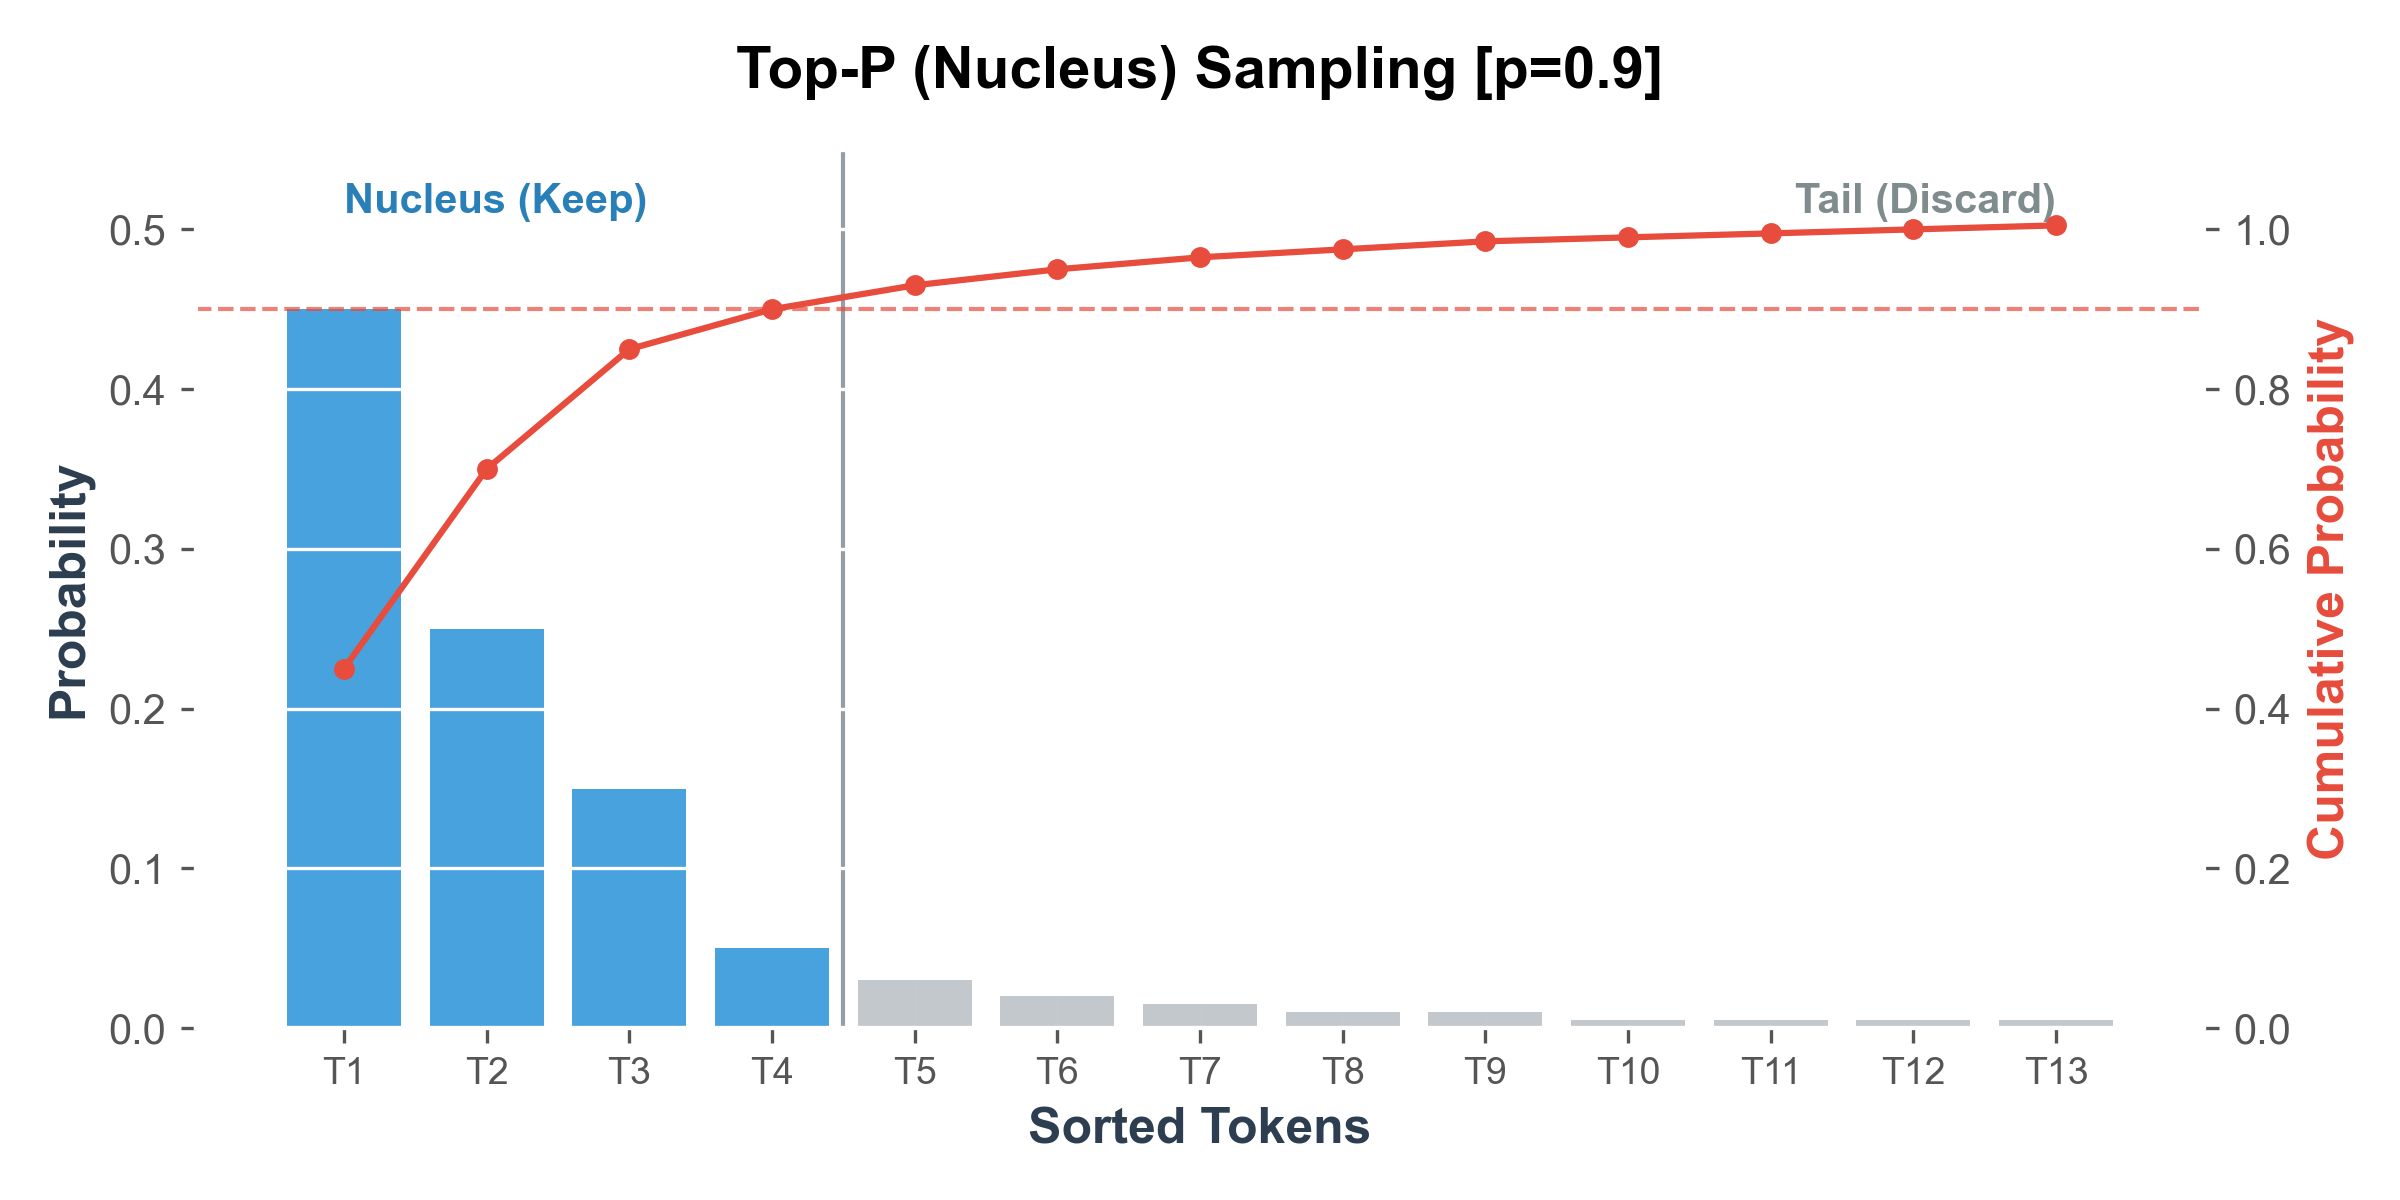
若概率为 [0.5,0.3,0.15,0.05],top_p=0.8 会保留前两个。另一个上下文的概率若更平均,达到同一阈值就需要更多候选。因此 top-p 的候选数会随上下文改变。
把整个流程接起来
对一个已加载的自回归模型,生成循环可以概括为:编码输入,运行网络,读取最后位置的词表分数,按选定策略产生一个 ID,再追加该 ID。遇到 EOS 或达到长度限制后,将输出 ID 解码回文本。
网络结构决定如何利用上下文,训练目标决定参数如何学习,而解码策略决定如何从概率分布中取出答案。把这三层分开,才容易定位“格式错误”“概率不合理”和“采样不合适”分别发生在哪里。