
“这部电影很好”和“这部电影并不好”包含相近的词,但顺序和否定词改变了含义。如果把词向量简单相加,模型很难保留这些结构。序列模型需要知道当前读到了什么,以及此前的内容如何影响当前判断。
循环神经网络 RNN 提供了一种直接方案:读一个 token,就更新一次记忆。本文先展开这次更新,再把它接成一个能够处理不同长度句子的分类器。
用隐藏状态保存前缀信息
设 是第 个输入向量, 是读到这个位置后的隐藏状态。最简单的 RNN 使用:
将输入映射到隐藏空间, 变换已有状态,tanh 再引入非线性。初始状态 可以设为零,也可以作为模型配置的一部分提供。
读到“电影”时,状态已经结合了前面的词;读到“不好”时,新的状态会在已有信息上更新。这里的“记忆”是一个固定长度的数值向量,不能将每个维度机械地解释为某一个词或语法标签。
时间展开后,参数仍然共享
将同一个 RNN 单元沿时间画开,可以看到 依次相连:
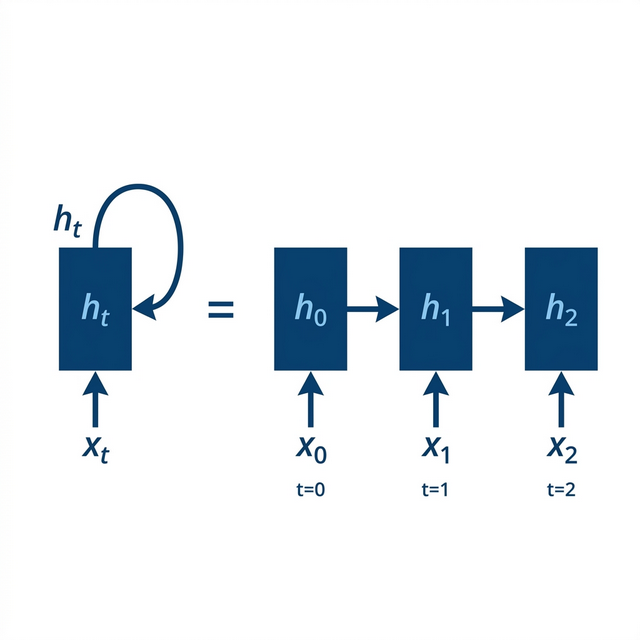
每个位置使用相同的 。这让模型可以处理不同长度的序列,也意味着同一个参数会通过多个时间步影响最终结果。训练时这些路径上的梯度需要汇总。
对于 batch-first 的输入,递推可以直译为下面的代码。这里只使用单层、单方向、无 dropout 的结构:
import torch
from torch import nn

class SimpleRNN(nn.Module):
    def __init__(self, input_size, hidden_size):
        super().__init__()
        self.input_layer = nn.Linear(input_size, hidden_size)
        self.hidden_layer = nn.Linear(hidden_size, hidden_size, bias=False)
        self.hidden_size = hidden_size

    def forward(self, x):
        # x: (batch, time, input_size), time must be positive.
        h = x.new_zeros(x.size(0), self.hidden_size)
        states = []
        for x_t in x.unbind(dim=1):
            h = torch.tanh(self.input_layer(x_t) + self.hidden_layer(h))
            states.append(h)
        return torch.stack(states, dim=1), h

model = SimpleRNN(10, 20)
sequence, last = model(torch.randn(2, 5, 10))
print(sequence.shape, last.shape)  # (2, 5, 20), (2, 20)
前一个状态是后一个状态的输入,所以不能把所有时间步当作独立样本计算。批次里的不同序列仍然可以并行处理。
output 和 h_n 分别是什么
PyTorch 的 nn.RNN 把递推封装成模块。设置 batch_first=True 后,输入和逐步输出以 batch 为第一维,但最终隐藏状态的维度约定不会随之改变。
对单层、单向模型:
| 张量 | 形状 | 含义 |
|---|---|---|
输入 x |
(B,T,E) |
每个位置的输入向量 |
输出 output |
(B,T,H) |
最后一层在所有时间步的隐藏状态 |
最终状态 h_n |
(1,B,H) |
这一层的最终隐藏状态 |
多层或双向模型的 h_n 第一维是“层数 × 方向数”。此时不能不看配置就使用 squeeze(0)。对于无 padding 的单层单向序列,output[:, -1] 与 h_n[0] 对应相同时间步;存在 padding 后,需要进一步考虑有效长度。
从序列表示到情感分类
一个基础分类器包含三个部分:embedding 将 token ID 转换成向量,RNN 将向量序列汇总成隐藏状态,线性分类头将状态映射成类别 logits。
例如二分类的输出是 (B,2),每行对应负面、正面两个分数。真实标签是形状 (B,) 的整数,交叉熵用这些标签计算损失。损失的梯度通过分类头返回 RNN,再返回 embedding,让整条数据流一起学习。
问题在于句长不同。假设第一句话只有 3 个 token,却补齐到了 8 个位置。即使 PAD embedding 为零,递推仍然会执行 。最后状态已经经过额外五次变换,不能直接当作真实句末状态。
用有效长度处理补齐位置
对单向 RNN,可以从逐步输出中取每条序列最后一个有效位置。另一种方式是使用 packed sequence,让 RNN 根据长度处理有效部分。下面给出后一种完整的前向过程,假设输入右侧补齐、PAD ID 为 0,且每条序列至少有一个 token。
import torch
from torch import nn
from torch.nn.utils.rnn import pack_padded_sequence

class RNNClassifier(nn.Module):
    def __init__(self, vocab_size, embed_dim=32, hidden_dim=64):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim, padding_idx=0)
        self.rnn = nn.RNN(embed_dim, hidden_dim, batch_first=True)
        self.classifier = nn.Linear(hidden_dim, 2)

    def forward(self, ids, lengths):
        embedded = self.embedding(ids)
        packed = pack_padded_sequence(
            embedded, lengths.cpu(), batch_first=True, enforce_sorted=False
        )
        _, h_n = self.rnn(packed)
        return self.classifier(h_n[-1])

ids = torch.tensor([[3, 5, 9, 0], [2, 8, 6, 4]])
lengths = torch.tensor([3, 4])
labels = torch.tensor([0, 1])
model = RNNClassifier(vocab_size=100)
logits = model(ids, lengths)
loss = nn.functional.cross_entropy(logits, labels)
loss.backward()
padding_idx 控制 embedding 中补齐行的行为,packed sequence 控制递推在哪些位置进行,两者解决的问题不同。这里没有包含优化器更新;如果要训练,应像普通网络一样在每次更新前清梯度,并在反向传播后调用 step()。
长距离依赖为什么难学
如果最终损失依赖很早的输入,反向传播就要沿时间链经过多次状态变换。局部导数的乘积可以写成:
这些矩阵连乘的效果可能逐渐缩小,也可能放大。Tanh 在饱和区域的导数接近零,进一步削弱远处信号。于是模型即使在前向过程中读过某个词,训练时也可能难以学会让很久之后的判断依赖这个词。
梯度裁剪可以限制过大的梯度范数,缓解更新失控;它不会恢复已经消失的长期梯度。把问题简单归结为“模型忘记了”,容易忽略这里真正困难的是如何训练这条长路径。
门控怎样改善信息保留
LSTM 引入细胞状态和输入、遗忘、输出门。细胞状态的更新包含加法路径:
这里 是遗忘门, 是输入门, 是输出门, 是候选内容。门并不是人为指定的开关:把 与 拼接后,分别经过可学习的线性层和 sigmoid,就得到 0 到 1 之间的门值;候选内容通常使用 tanh。若遗忘门接近 1、输入门接近 0,细胞状态就倾向于保留旧信息。
GRU 使用更新门和重置门,不再单独维护细胞状态。在一种常见约定下,:更新门 决定写入候选状态的比例,重置门控制计算候选状态时使用多少旧状态。有些实现对更新门采用相反的命名约定,阅读公式和代码时需要对照确认。门控改善了信息保留方式,但网络仍然沿时间递推。
在接口上,LSTM 返回的最终状态还包含 (h_n,c_n),不能只替换类名后假设所有返回值完全相同。完整约定见 PyTorch RNN 文档。
RNN 留下的两个结构问题
RNN 把整个前缀压进固定长度状态,并要求每一步等待前一步。前者使信息选择与保留承担很大压力,后者限制时间维度上的并行。
Attention 的出发点正好不同:保留多个位置的表示,再根据当前需要直接读取相关位置。理解了 RNN 的状态、时间依赖和训练路径,就更容易理解 Transformer 为什么把“递推记忆”改成了“按内容访问上下文”。