
Transformer 的核心问题是:一个 token 应该怎样读取其他位置的信息,又怎样把读到的信息变成新的表示?Attention 解决按内容读取的问题,位置表示提供顺序,前馈网络加工特征,残差与归一化让这些操作能够反复堆叠。
本文把这些部分放在同一条计算路径上。输入从 (batch,tokens) 的整数 ID 开始,经过网络变成 (batch,tokens,vocab) 的分数,最后用于预测下一 token。
用 Q、K、V 分开描述匹配与内容
可以把 Attention 想成一次检索:Query 表达当前需要什么,Key 表达每个候选如何被匹配,Value 提供实际取回的内容。匹配依据与读取内容分开,网络就能分别学习这两种表示。
设一条序列的输入为 。在 self-attention 中,Q、K、V 都由这条序列经过不同线性投影得到:
若 query 与 key 的维度为 ,value 的维度为 ,那么 的形状是 (T,T)。第 行、第 列的分数表示位置 对位置 的匹配程度。它与两个位置在数组中离得多近并不是同一个概念。
注意力是经过归一化的加权读取
缩放点积注意力写成:
Softmax 沿 key 维度计算,使每一行权重加起来等于 1。输出的第 行就是所有 value 按第 行权重加权后的结果,因此输出形状为 (T,d_v)。
以一个 query 为例,假设两个候选的分数是 [2,0],softmax 权重约为 [0.881,0.119]。若它们的 value 是 [1,0] 和 [0,2],读取结果就是 [0.881,0.238]。网络没有硬性选中一个位置,而是保留了可微的软选择。
为什么除以 ?在各维近似独立、零均值且单位方差时,点积的方差随 增长。分数变得过大,会使 softmax 过早集中到少数项。缩放帮助控制尺度,让训练更容易进行。
自回归预测需要 causal mask
如果当前位置的目标是下一个 token,训练时不能提前读取后面的答案。Causal mask 将未来位置的分数设为负无穷,使其在 softmax 后的权重为零。
长度为 4 的序列,其允许读取的位置可以画成:
         key 0  key 1  key 2  key 3
query 0    ✓      ×      ×      ×
query 1    ✓      ✓      ×      ×
query 2    ✓      ✓      ✓      ×
query 3    ✓      ✓      ✓      ✓
这里允许位置读取自己,因为该位置的输入 token 已知,它预测的是下一个 token。Mask 应在 softmax 前应用;先归一化再把未来权重清零,会破坏权重和为 1 的条件。
Padding mask 则排除补齐位置。实际库对布尔 mask 的约定可能不同,不能仅凭 True 就判断它表示允许还是屏蔽。全被屏蔽的一行还需要特殊处理,避免得到无效的归一化结果。
多头把读取分成多个子空间
单个头只进行一次相似度匹配和加权读取。多头注意力为不同头学习不同投影,让模型同时形成多组读取结果,再拼接并投影回隐藏维度。
常见配置下,隐藏维度 。投影后的 (B,T,D) 会重排为 (B,H,T,d_h)。每个头独立计算 (T,T) 权重,输出再从 (B,H,T,d_h) 变回 (B,T,D)。
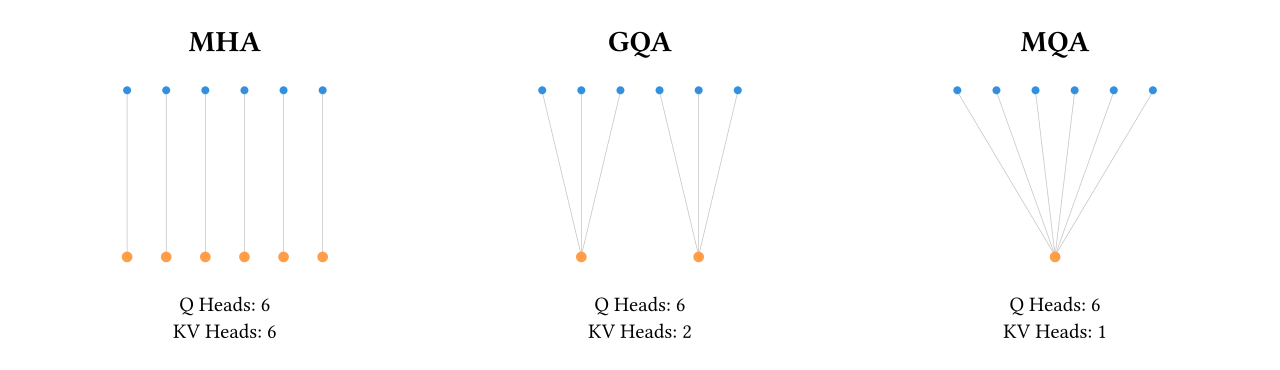
MHA 为每个 query 头保留对应的 key/value 头。GQA 让一组 query 头共享一对 KV 头,MQA 则让所有 query 头共享一对 KV 头。它们减少的是 KV 表示的数量,query 头仍可以保留多个。不同头有机会学到不同关系,但不能事先认定某个头必然对应某一条语法规则。
位置从哪里进入网络
仅考虑没有位置表示、没有 mask 的 self-attention,调换输入顺序,输出会跟着进行相同的排列。这叫置换等变性:它能够根据内容匹配,却没有显式表达谁在前、谁在后。
一种办法是在 token embedding 上加位置向量。正弦位置编码为:
不同维度使用不同频率,因此同一个位置对应一组独特的相位组合。
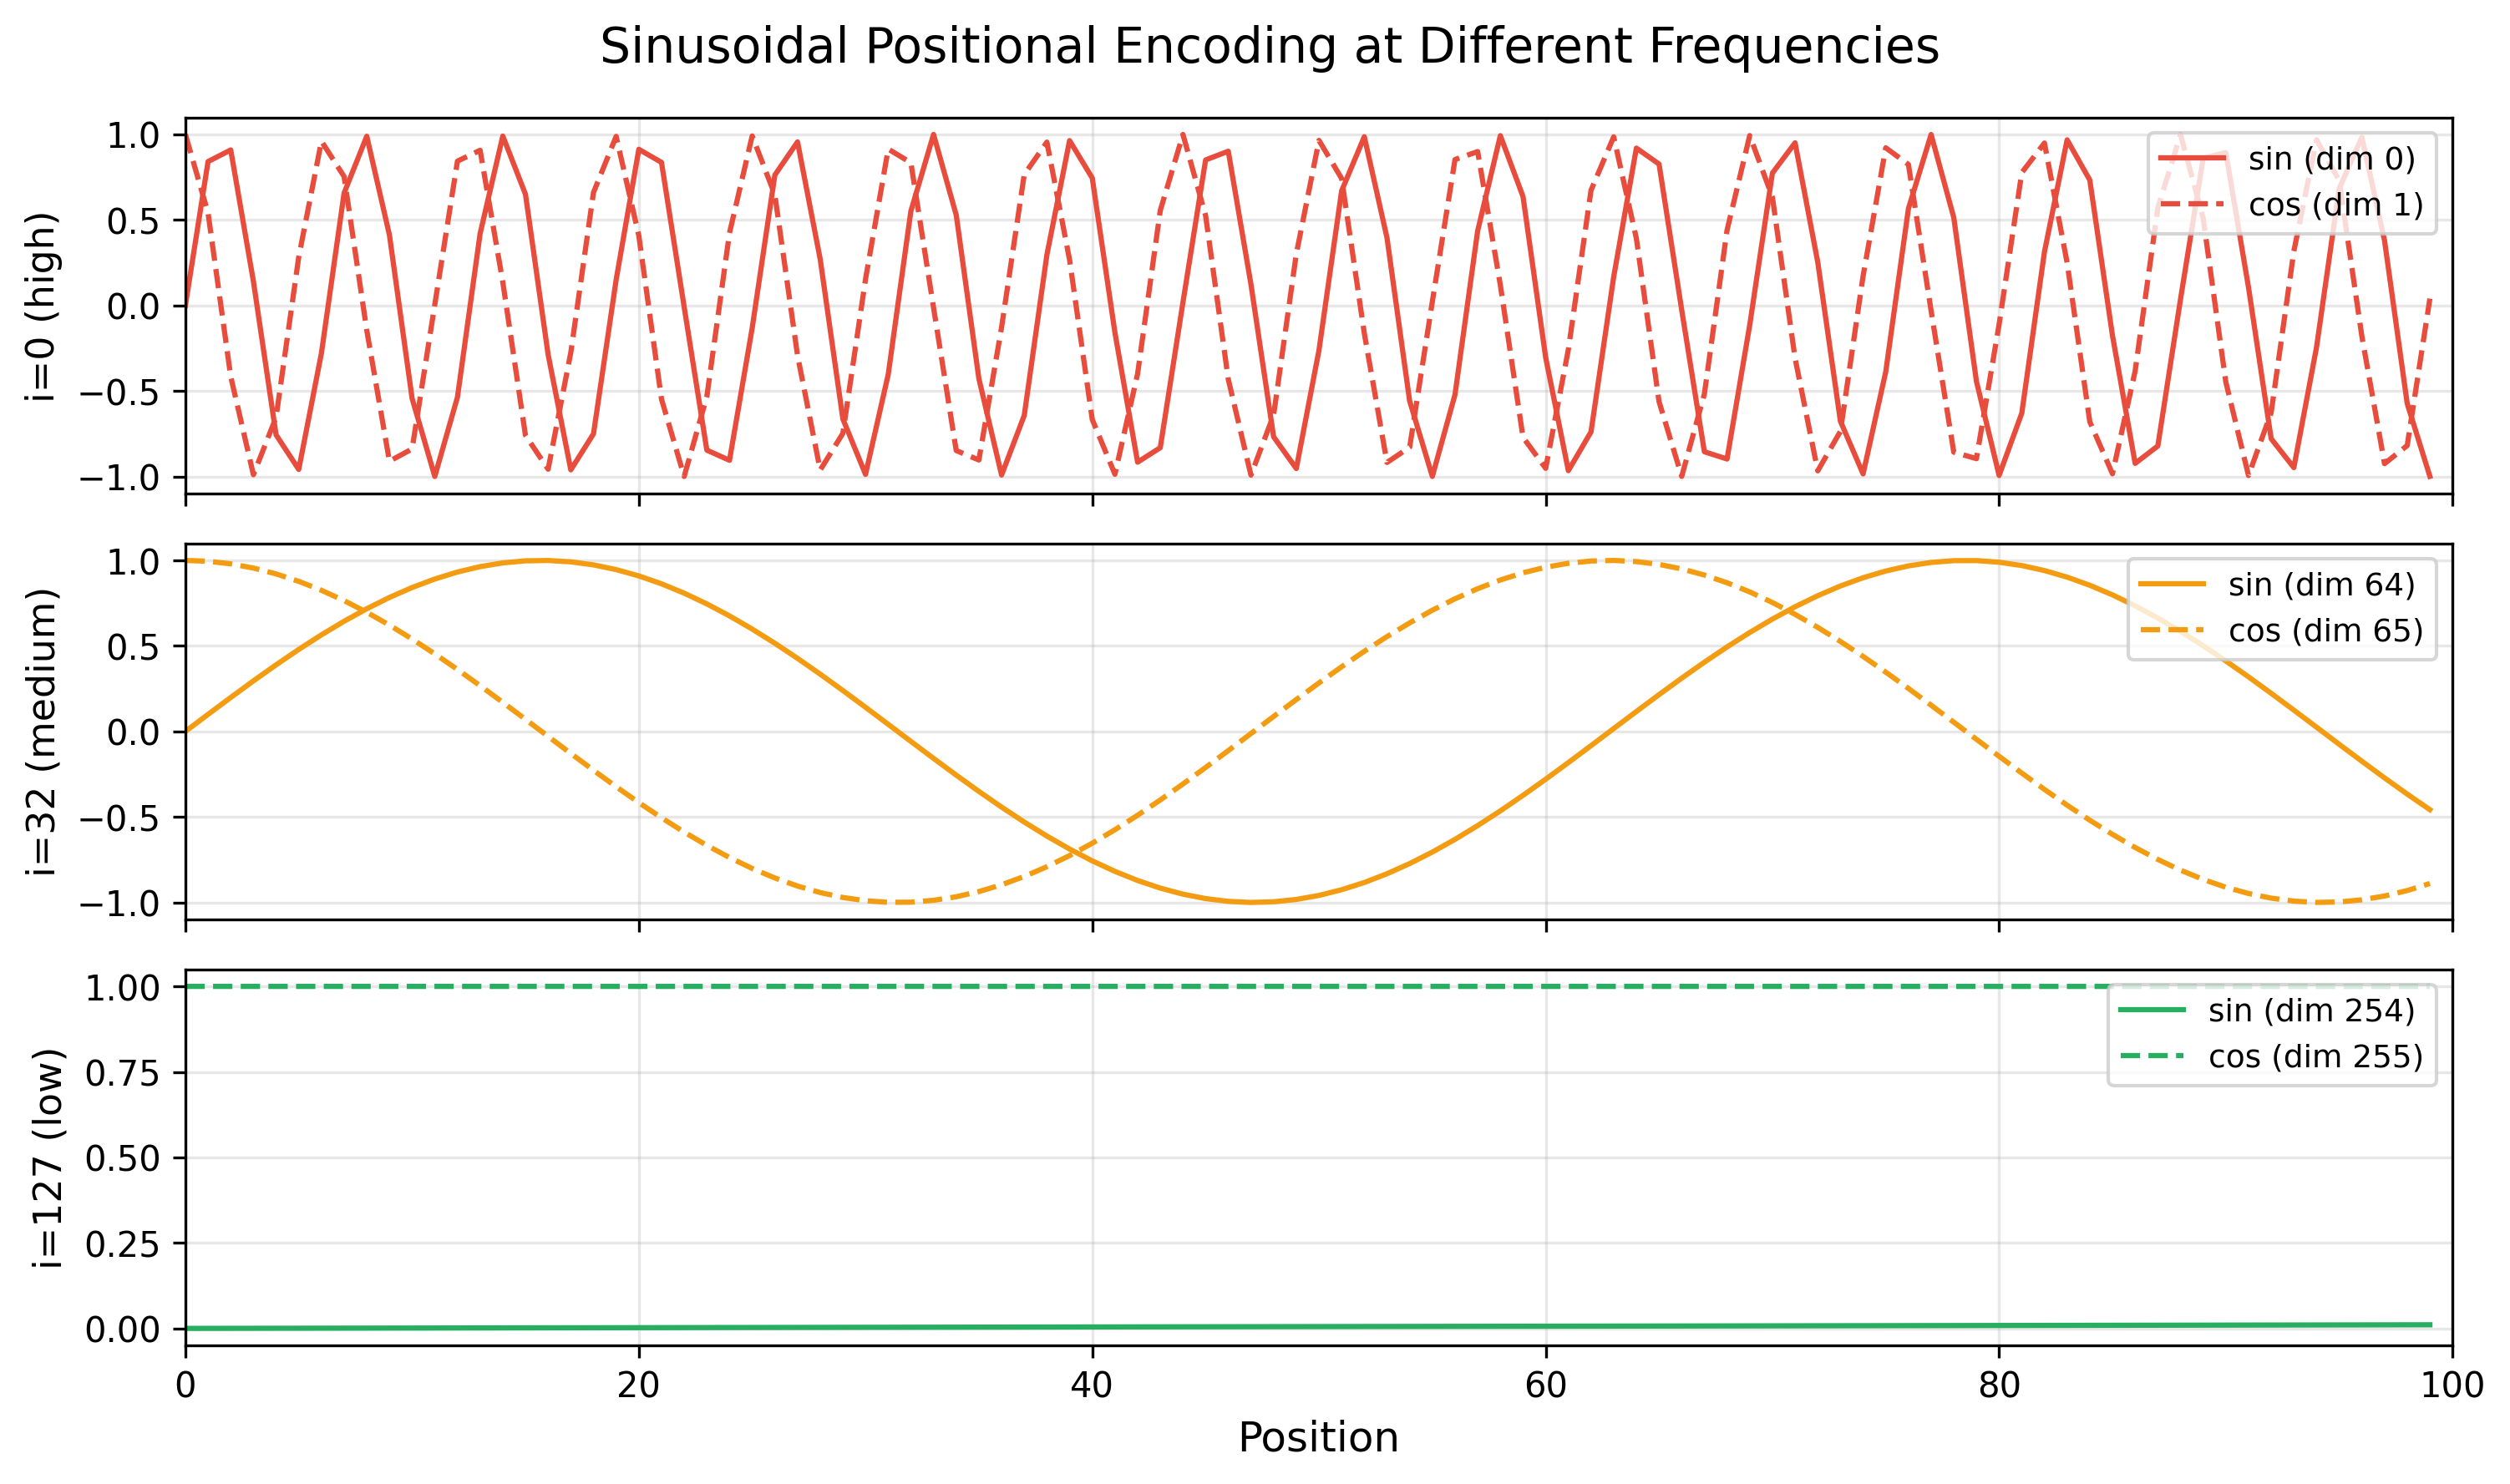
也可以把位置向量作为参数学习。两者都会使相同 token 在不同位置获得不同的输入表示。正弦公式能够计算超出训练范围的位置,但模型是否能正确处理更长序列,仍取决于训练与结构,不能仅由公式的可计算性保证。
RoPE 把位置信息写进旋转
RoPE 按位置旋转 query 和 key 的二维分量,而不是简单把位置向量加到输入。若 表示位置 的旋转,在一致的旋转定义下有:
对一个二维分量,旋转可以具体写成:
不同分量对使用不同的频率 。两个位置的旋转在点积中组合成角度之差,这使相对位移 进入匹配分数。内容向量 仍然参与计算,因此分数并非只由距离决定。旋转保留向量范数,且可以在不同二维分量上使用不同频率。
理解这一步只需抓住位置与内容的分工:内容决定“匹配什么”,位置变换让匹配同时区分“在什么相对位置”。正弦加法、可学习位置向量和 RoPE 是不同方案,不需要在同一个基础实现中全部叠加。
为什么 Attention 后面还需要 FFN
Attention 主要在不同位置之间聚合信息。FFN 则对每个位置独立应用相同的非线性变换,例如:
中间维度通常比输入维度大,最后再投影回来。非线性让网络能够重新组合读到的特征。不同位置共享 FFN 参数,但计算时不会通过这一层直接读取其他 token。
门控变体 SwiGLU 使用两条投影分支,让一条分支调节另一条分支的内容:
“跨位置交换信息”和“逐位置加工特征”交替进行,才构成了逐层更新表示的过程。
残差连接与归一化怎样接上去
直接堆叠很多变换,梯度需要连续穿过每个子层。残差连接 增加了一条直接传递输入的路径,让子层可以学习增量。
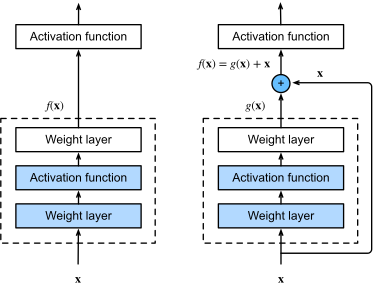
LayerNorm 在每个 token 的隐藏维度上计算均值与方差,再执行归一化和可学习的仿射变换:
RMSNorm 使用均方根控制尺度,不做均值中心化:
这里 是可学习的缩放参数, 用于数值稳定。它们都作用于特征维度,不是把不同长度的句子混在一起计算一个 batch 均值。
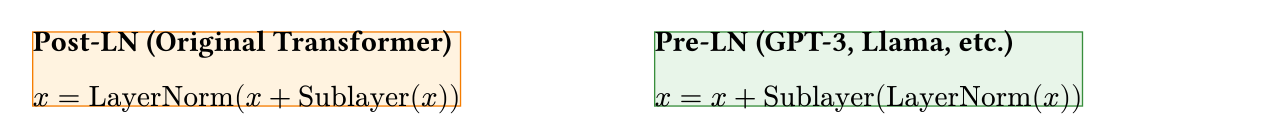
Post-Norm 在残差相加后归一化,Pre-Norm 在子层变换前归一化。采用 Pre-Norm 时,一个 decoder-only block 可以写成:
图中使用 LayerNorm 表示归一化;具体模型也可以采用 RMSNorm。这里的 Pre-Norm 是一种常见结构选择,与原始 Transformer 的 Post-Norm 设计需要区分。
把这些部件组装成一个小模型
下面的例子包含 MHA、causal mask、Pre-Norm、FFN、可学习位置 embedding 和词表输出层。为看清数据流,省略 padding、dropout 等扩展;输入必须是没有补齐的有效序列,且长度不超过 max_length。需要安装 PyTorch。
import math
import torch
from torch import nn

class CausalAttention(nn.Module):
    def __init__(self, dim, heads):
        super().__init__()
        assert dim % heads == 0
        self.heads = heads
        self.head_dim = dim // heads
        self.qkv = nn.Linear(dim, 3 * dim, bias=False)
        self.output = nn.Linear(dim, dim, bias=False)

    def forward(self, x):
        b, t, d = x.shape
        qkv = self.qkv(x).reshape(b, t, 3, self.heads, self.head_dim)
        q, k, v = qkv.permute(2, 0, 3, 1, 4).unbind(0)
        scores = q @ k.transpose(-2, -1) / math.sqrt(self.head_dim)
        future = torch.ones(t, t, device=x.device, dtype=torch.bool).triu(1)
        weights = scores.masked_fill(future, float('-inf')).softmax(-1)
        mixed = (weights @ v).transpose(1, 2).reshape(b, t, d)
        return self.output(mixed)

class DecoderBlock(nn.Module):
    def __init__(self, dim, heads):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim)
        self.attention = CausalAttention(dim, heads)
        self.norm2 = nn.LayerNorm(dim)
        self.ffn = nn.Sequential(
            nn.Linear(dim, 4 * dim), nn.GELU(), nn.Linear(4 * dim, dim)
        )

    def forward(self, x):
        x = x + self.attention(self.norm1(x))
        return x + self.ffn(self.norm2(x))

class TinyLM(nn.Module):
    def __init__(self, vocab_size=100, dim=32, heads=4, max_length=128):
        super().__init__()
        self.tokens = nn.Embedding(vocab_size, dim)
        self.positions = nn.Embedding(max_length, dim)
        self.blocks = nn.Sequential(DecoderBlock(dim, heads), DecoderBlock(dim, heads))
        self.norm = nn.LayerNorm(dim)
        self.output = nn.Linear(dim, vocab_size, bias=False)

    def forward(self, ids):
        positions = torch.arange(ids.size(1), device=ids.device)
        x = self.tokens(ids) + self.positions(positions)
        return self.output(self.norm(self.blocks(x)))

model = TinyLM()
sequence = torch.randint(0, 100, (2, 9))
logits = model(sequence[:, :-1])
loss = nn.functional.cross_entropy(
    logits.reshape(-1, 100), sequence[:, 1:].reshape(-1)
)
loss.backward()
print(logits.shape)  # torch.Size([2, 8, 100])
这段代码把整条链闭合了:输入 ID 变成向量,经过两层 block,输出每个位置的词表 logits,再与右移一位的目标计算交叉熵。随机 token 只用于演示形状与求导,不是有意义的语言训练数据。
Encoder、decoder 与 cross-attention
Encoder-only 通常允许每个有效位置读取整个输入,适合表示学习或分类。Decoder-only 使用 causal mask,适合自回归生成。Encoder-decoder 则先编码源序列,再让解码器一边读取已生成的目标前缀,一边通过 cross-attention 读取源表示。
Cross-attention 与 self-attention 使用同一类加权读取公式,但 query 来自目标序列,key/value 来自源序列。因此分数矩阵可以是 (目标长度,源长度),不必是方阵。
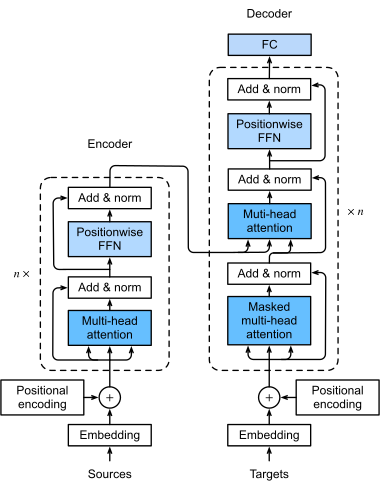
图中的解码器包含三部分:对目标前缀做 masked self-attention,对编码器输出做 cross-attention,再经过 FFN。这解释了翻译模型为何既能利用完整的源句,又不会偷看还未生成的目标词。
训练时,已知目标前缀可以借助 mask 在同一次计算中处理多个位置;自回归生成时,新的 token 仍然要等待前一步结果。Transformer 改变了网络内部的信息交换方式,并没有取消生成任务本身的因果顺序。原始 encoder-decoder 结构可参考 Attention Is All You Need。