
神经网络在公式上可能只有几次矩阵运算,实际运行却涉及内存分配、数据读取、线程调度和结果写回。GPU 算得很快,仍然可能花大量时间等待数据。理解执行模型,才能判断优化应放在计算还是搬运上。
本文先建立存储与并行层次,再用一个完整向量加法说明 Triton 如何定位数据,最后解释为什么 softmax 适合按行融合。
算力与带宽是两种不同的限制
大矩阵乘法可以反复使用同一块输入,执行大量乘加;逐元素操作通常每读取一个数,只做很少的计算。前者更容易利用算力,后者更容易被内存带宽限制。
算术强度描述每传输一个字节执行多少次运算。以 FP32 向量加法 为例,每个元素读取两个 4 字节输入,再写出一个 4 字节结果,做一次加法,理想流量就是 12 字节。这个操作很难靠增加计算单元获得同比例加速。
一种简化的时间下界是:
对于很小的张量,kernel 启动等固定开销也可能占主导。因此同一种操作在不同形状和 batch 下,瓶颈可能变化。
数据放在哪里,决定访问成本
模型权重、大输入和长期状态主要放在设备全局内存中。数据中心 GPU 常使用 HBM;寄存器和共享内存位于芯片内部,容量更小,适合保存频繁复用的工作集。主机 DRAM 又是另一层,需要经过设备与主机之间的传输路径。
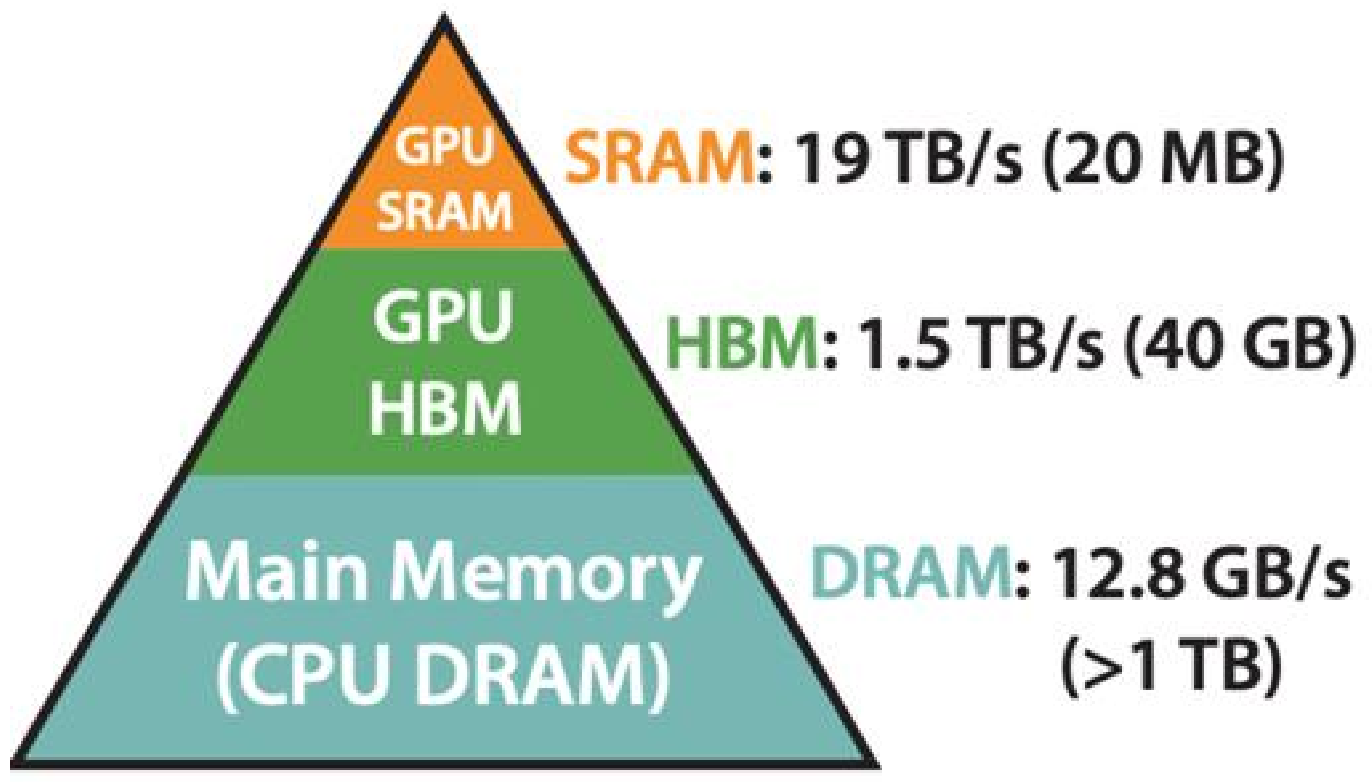
图中的容量和带宽对应特定硬件示例。需要理解的是层次差异:大容量存储可以放下整个模型,而快速片上存储只能容纳当前正在处理的一部分数据。
这促使很多 kernel 采用分块思路:从全局内存取一块数据,在片上进行多次计算,最后写回结果。块过大可能放不下,寄存器使用过多还会限制并发,甚至发生 spill,让部分临时值落到更慢的存储路径。
线程、线程块和网格怎样分工
在 CUDA 的执行模型中,一个 kernel 启动一组线程块,所有线程块组成 grid。一个线程块通常被调度到某个 SM 上执行,块内线程可以使用共享内存协作;不同线程块不能把共享内存当作整个 GPU 通用的共享空间。
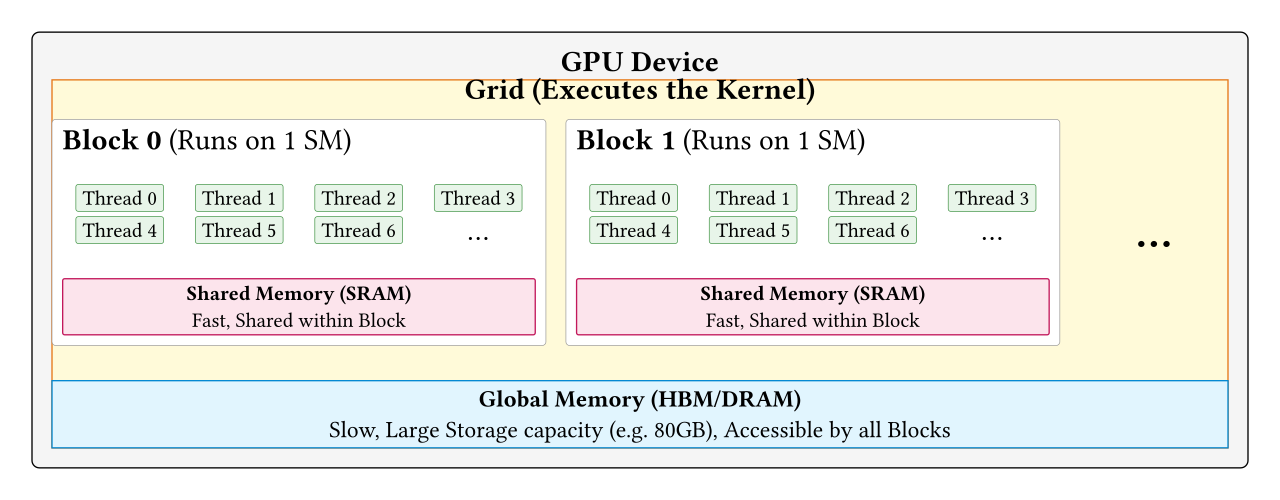
把向量元素分给线程,是一种常见映射,但不是固定的一元素一线程规则。一个线程可以处理多个元素,复杂运算也会让多个线程合作处理同一块数据。底层执行还涉及 warp 等调度单位,不能仅从 Python 张量元素数直接推断线程数。
Triton 让开发者用一个 program 处理一块数组,编译器再安排底层线程与指令。这更接近“对一个数据块做向量化计算”的写法。
一个 program 如何找到自己的数据
假设每个 program 处理 BLOCK 个元素,编号为 pid,它的起始索引就是 pid * BLOCK。tl.arange(0,BLOCK) 生成块内相对索引,相加得到这一块在全局数组中的位置。
如果数组长度为 10,而块大小为 4,就需要 3 个 program。最后一个会生成索引 [8,9,10,11],其中后两个越界,因此必须通过 mask 阻止无效读取与写入。
下面的示例包含 kernel、启动代码和结果校验。需要安装 PyTorch、Triton,并使用受支持的 CUDA GPU。
import torch
import triton
import triton.language as tl

@triton.jit
def add_kernel(X, Y, Z, N, BLOCK: tl.constexpr):
    offsets = tl.program_id(0) * BLOCK + tl.arange(0, BLOCK)
    valid = offsets < N
    x = tl.load(X + offsets, mask=valid, other=0.0)
    y = tl.load(Y + offsets, mask=valid, other=0.0)
    tl.store(Z + offsets, x + y, mask=valid)

def vector_add(x, y):
    assert x.is_cuda and y.is_cuda
    assert x.device == y.device and x.dtype == y.dtype
    assert x.ndim == y.ndim == 1 and x.shape == y.shape
    assert x.is_contiguous() and y.is_contiguous()
    output = torch.empty_like(x)
    n = x.numel()
    if n:
        block = 256
        add_kernel[(triton.cdiv(n, block),)](x, y, output, n, BLOCK=block)
    return output

x = torch.randn(10003, device="cuda")
y = torch.randn_like(x)
result = vector_add(x, y)
torch.testing.assert_close(result, x + y)
tl.load 和 tl.store 接收的是指针加偏移量。BLOCK 声明为 tl.constexpr,使编译器在生成这个 kernel 版本时知道块大小。选择 256 是一个明确的示例配置,不表示 Triton 会自动替我们搜索所有块大小;自动调参需要单独配置。
算子融合为什么能减少流量
考虑 。如果每个步骤独立执行,中间结果可能被写入全局内存,再被下一个 kernel 读回来。融合后,一个 kernel 可以读入 ,连续完成这些计算,只写出 。
融合节省的是中间张量的读写与启动开销。输入和最终输出仍然要传输,融合后的工作集也仍受寄存器与共享内存约束。现代编译器可能自动融合部分操作,所以性能分析应观察实际执行,而不是假设每个 Python 运算符都对应一次独立 kernel。
Softmax 增加了归约依赖
对一行 ,稳定 softmax 需要先计算最大值,再计算指数和:
与向量加法不同,某个输出元素依赖整行的最大值和总和。若把各步骤拆开,会产生减法结果、指数结果等中间张量,并多次经过全局内存。
当一行的工作集能够有效放在片上时,可以让一个 program 负责整行:读入、求最大值、求指数和、归一化、写回。这样协作范围与数据依赖范围一致。
按行融合时,stride 和边界不能省略
二维张量的第 行起点为 base + r * stride,其中 stride 表示跨过一行所需的元素偏移,不应永远假设它等于逻辑列数。若列数不是 2 的幂,可以使用更大的块,并屏蔽多余位置。
import triton
import triton.language as tl

@triton.jit
def row_softmax(X, Y, X_STRIDE, Y_STRIDE, N, BLOCK: tl.constexpr):
    row = tl.program_id(0)
    cols = tl.arange(0, BLOCK)
    values = tl.load(X + row * X_STRIDE + cols,
                     mask=cols < N, other=-float('inf'))
    values = values.to(tl.float32)
    numerator = tl.exp(values - tl.max(values, axis=0))
    output = numerator / tl.sum(numerator, axis=0)
    tl.store(Y + row * Y_STRIDE + cols, output, mask=cols < N)
这里展示核心 kernel,假设每行至少一个有效元素、输入值有限,并且行内元素连续,即列方向 stride 为 1。启动端需要分配输出,以行数构造 grid,并设置 BLOCK=triton.next_power_of_2(N)。无效位置填负无穷,使其不影响最大值,指数后也不影响求和。这个实现适合行宽受控的场景;任意长的一行不一定能够高效地交给单个 program。
这种融合与片上资源之间的取舍,在 Triton Fused Softmax 教程中有更完整的实现和测量示例。
怎样确认优化有效
先用参考实现检查数值误差,再测量时间。测试应覆盖不能整除块大小的长度,避免只有整齐输入才能正确运行。GPU 操作通常异步提交,测量时需要同步或使用合适的事件计时,并将首次编译与预热排除或单独报告。
最后同时记录张量形状、dtype、硬件、重复次数,以及是否计入拷贝和分配。这样得到的“更快”,才对应一个清楚的工作负载,也能解释为什么同一 kernel 换一组输入后收益会变化。