
一个预训练语言模型学会了续写文本,却不一定会按照我们需要的格式回答问题。假设要把设备报修描述转换成包含“设备、故障、紧急程度”的 JSON:模型可能理解描述,但漏字段、加解释,或对同一种故障使用不同标签。监督微调(Supervised Fine-Tuning,SFT)通过输入与期望输出的示例,让模型适应这样的任务。
SFT 描述的是训练目标和数据形式;LoRA 描述的是如何更新参数。两者是不同层面的问题:同一份 SFT 数据既可以用于全参数微调,也可以只训练 LoRA 适配器。先把数据和损失弄清楚,才能判断省下来的参数究竟在哪里。
一条对话怎样成为训练样本
可以先用消息列表保存任务数据:
{
  "messages": [
    {"role": "system", "content": "提取设备、故障和紧急程度,只输出 JSON。"},
    {"role": "user", "content": "会议室投影仪无法开机,明天才会用。"},
    {"role": "assistant", "content": "{\"设备\":\"投影仪\",\"故障\":\"无法开机\",\"紧急程度\":\"普通\"}"}
  ]
}
真正送入模型前,还要使用与模型匹配的 chat template,把角色、消息边界和结束标记转换成 token 序列。训练样本包含已经完成的 assistant 回答,因此不应像推理时那样,在样本末尾额外打开一个待生成的 assistant 消息。
设序列为 。模型仍然用前面的 token 预测下一个 token,但我们可以只在 assistant 回答对应的位置计算损失:
其中 是需要学习的目标位置集合。用户问题仍在输入里,提供条件;不计入损失并不意味着把它从上下文删掉。
实现时通常复制 input_ids 得到 labels,把 system、user 和 padding 对应位置改成 -100。交叉熵会忽略这些标签。assistant 结束标记是否纳入训练、哪些消息边界需要监督,应与所用模板和训练约定一致。多轮对话还要决定监督所有 assistant 回合,还是只监督最后一轮。
标签边界必须在 token 层面可靠识别。优先使用模板提供的 assistant mask 或经过验证的数据整理器;直接在拼接字符串里搜索“assistant”容易误匹配正文,也可能被分词边界打断。
下一 token 的错位发生在哪里
下面的函数假设 logits 对应完整输入,labels 已经做好上述屏蔽。位置 的输出要预测位置 的标签,所以两者需要错开一位:
import torch
import torch.nn.functional as F

def causal_loss(logits, labels):
    prediction = logits[:, :-1, :].contiguous()
    target = labels[:, 1:].contiguous()
    if not torch.any(target != -100):
        raise ValueError("The batch has no supervised target tokens.")
    return F.cross_entropy(
        prediction.reshape(-1, prediction.size(-1)),
        target.reshape(-1),
        ignore_index=-100,
    )
这解释了手工计算损失的过程。使用 Hugging Face 的 causal LM 并传入 labels 时,模型通常已经在内部执行这个错位,不要提前把标签再移动一次。
在正式训练前,先检查几个样本:把有效 label 解码出来,看监督的是否确实是期望回答;确认截断没有把回答全部删掉;检查 padding 没有进入损失。数据还应先按来源或任务实体划分训练集和验证集,再做切分与扩充,避免同一条内容的近似副本同时出现在两边。
全参数微调的内存花在哪里
全参数训练不仅要存模型权重,还要保存梯度、优化器状态、前向激活和临时工作区。以 Adam 为例,每个可训练参数通常还有一阶、二阶矩状态;混合精度训练也可能保留更高精度的参数副本。具体字节数依赖 dtype 和实现,不能只用权重文件大小推断训练显存。
例如 70 亿参数以每个参数 2 字节保存,权重本身约为 14 GB,尚未包括上述训练状态。序列变长或 batch 变大时,激活也会明显增长。LoRA 主要减少可训练参数及其梯度、优化器状态,基础模型仍然需要加载,许多激活也仍然存在。
用两个小矩阵表示参数更新
对线性层采用列向量记法:,其中 。全参数微调直接改变 ;LoRA 冻结它,将更新限制为两个小矩阵的乘积:
是秩,决定低秩分支的容量; 控制它相对原输出的缩放。因为 的秩最多为 ,模型只能在一个受限的更新空间内适应任务。这是一种有用的结构假设,并不保证任意任务都能由很小的 完成。LoRA 论文给出了这一方法及实验依据。
若原矩阵为 ,共有 16,777,216 个参数;取 ,两个适配矩阵只有 个参数,是原矩阵的 。这个比例只针对该层可训练矩阵,不能直接当成整次训练的显存缩减比例。
为什么一个随机初始化、另一个初始化为零
如果令 ,则初始 ,插入 LoRA 后模型仍然保持原来的输出。与此同时,把 初始化为小的随机值,就能让 在第一次反向传播时获得有效梯度。
第一次更新时, 的梯度会因为 而为零;等 更新后, 也可以开始学习。如果把两者都初始化为零,那么这两个矩阵的梯度会相互被零因子阻断,低秩分支就无法启动。
下面把一个已有的 nn.Linear 包装起来,保留它的设备、dtype 和偏置:
import math
import torch
from torch import nn

class LoRALinear(nn.Module):
    def __init__(self, base, rank=8, alpha=16):
        super().__init__()
        if rank < 1:
            raise ValueError("rank must be positive")
        self.base = base
        self.base.requires_grad_(False)
        self.scale = alpha / rank
        self.A = nn.Parameter(base.weight.new_empty(rank, base.in_features))
        self.B = nn.Parameter(base.weight.new_zeros(base.out_features, rank))
        nn.init.kaiming_uniform_(self.A, a=math.sqrt(5))

    def forward(self, x):
        return self.base(x) + (x @ self.A.T @ self.B.T) * self.scale

base = nn.Linear(16, 12)
layer = LoRALinear(base, rank=4, alpha=8)
x = torch.randn(2, 16)
assert torch.allclose(layer(x), base(x))
loss = layer(x).square().mean()
loss.backward()
assert base.weight.grad is None
assert layer.B.grad is not None
冻结权重使用 requires_grad_(False),不要把基础分支整个包进 no_grad()。即使权重不需要梯度,梯度仍可能需要经过这次运算传给上游的可训练层;禁用计算图会切断这条路径。
在实际模型中接入 LoRA
先观察模型中线性层的名称,再选择目标模块。注意力里的 Q、K、V、输出投影和 FFN 都可以成为候选,但不同架构可能使用独立投影,也可能把 QKV 合在一个矩阵里。照抄另一种架构的名字,可能找不到模块或漏掉预期层。
以下代码接在第五篇加载 Qwen 模型之后,使用 PEFT 为其中的 q_proj、v_proj 添加适配器:
from peft import LoraConfig, get_peft_model

config = LoraConfig(
    r=8,
    lora_alpha=16,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
)
model = get_peft_model(model, config)
model.print_trainable_parameters()
optimizer = torch.optim.AdamW(
    (p for p in model.parameters() if p.requires_grad),
    lr=2e-4,
)
model.train()
学习率只是实验起点,需要结合数据量、有效 batch、训练步数和验证结果调整。model.train() 也不能省略:前面推理时使用的 eval() 会关闭 dropout 等训练行为。
训练循环仍是清梯度、前向、反向、更新。每个 batch 应提供 input_ids、attention_mask 和处理好的 labels,移动到相应设备后用 model(**batch).loss 获取损失。Trainer 等工具封装的是这段调度,并不会自动替我们决定正确的标签边界。使用梯度累积时,还要让损失缩放、更新频率和学习率调度保持一致。
怎样比较效果,怎样保存结果
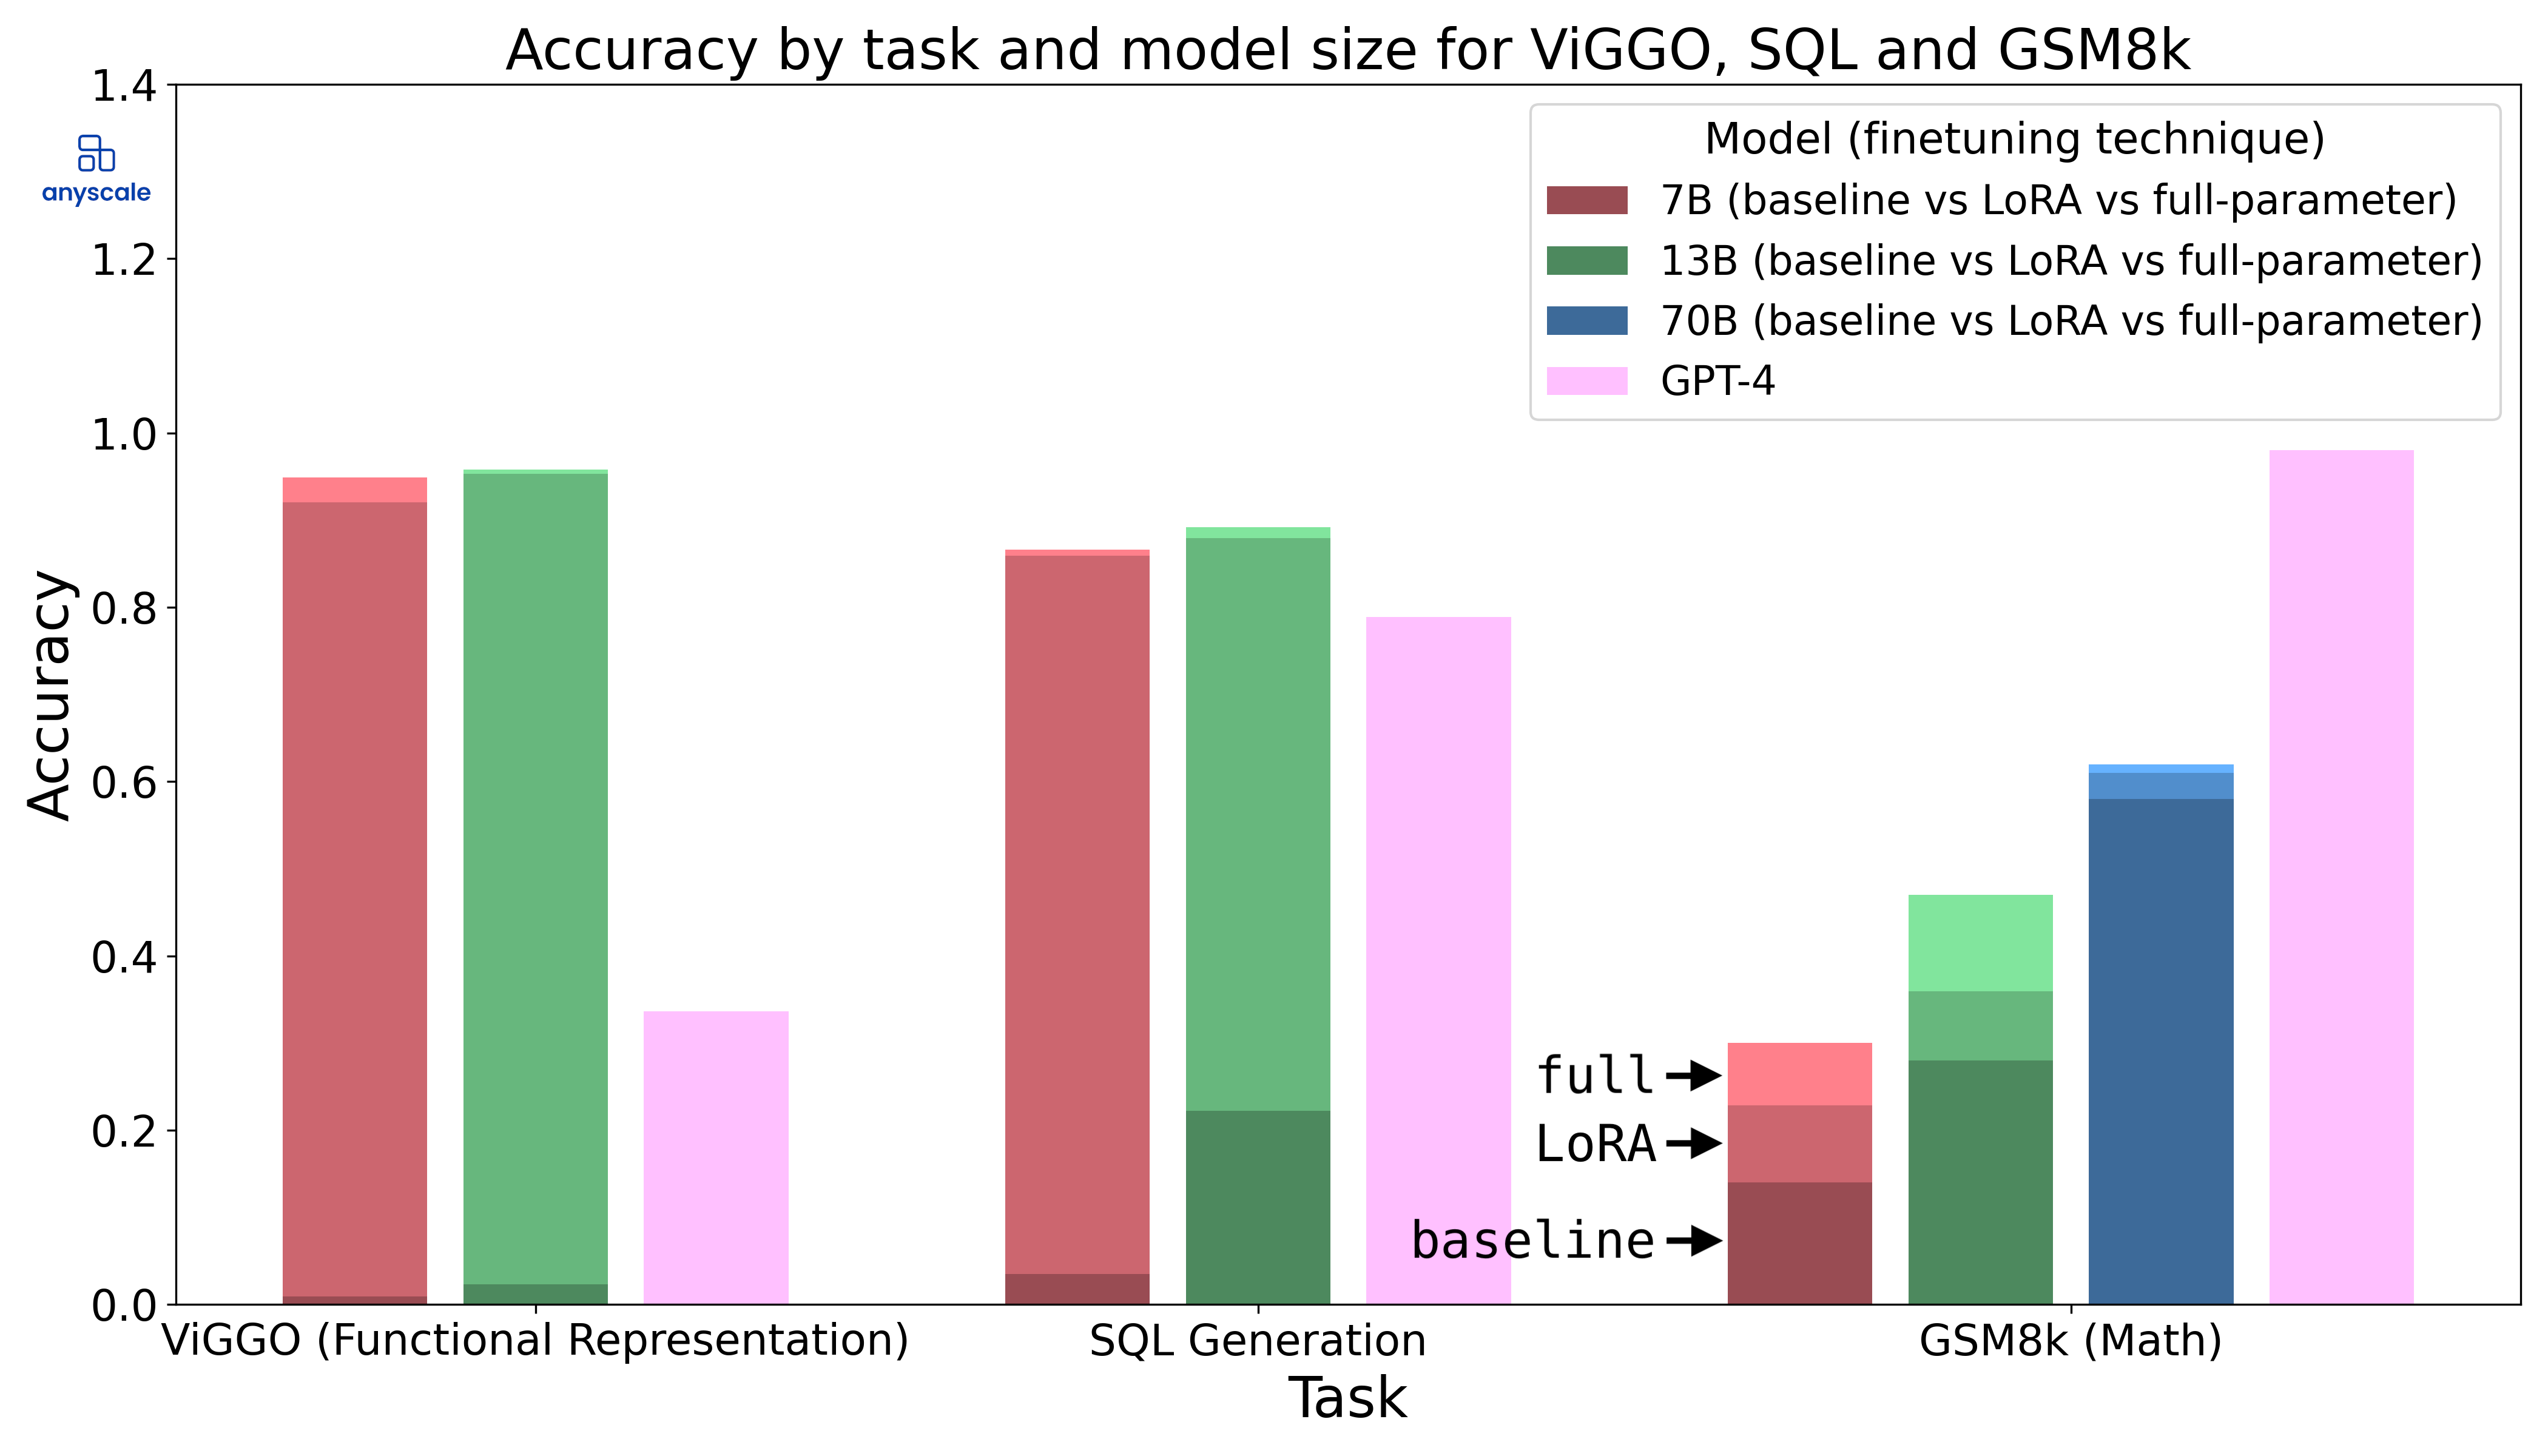
这张图来自 Anyscale 的 Llama 2 微调实验。它说明在这些实验设置中,少量可训练参数可以获得有竞争力的效果;不能据此断言 LoRA 在任何数据集上都与全参数微调等价。比较时应同时报告任务指标、格式正确率、训练资源,以及对原有能力的影响。
PEFT 模型可以使用 model.save_pretrained("adapter") 保存适配器,并用 tokenizer.save_pretrained("adapter") 保存 tokenizer。通常保存的是适配器及其配置,而不是完整基础权重;若配置了额外可训练模块,也需要一并保存。基础模型的标识和版本应记录下来,加载时先恢复匹配的基础模型,再用 PeftModel.from_pretrained(base_model, "adapter") 接入适配器。具体接口见 PEFT 文档。
对于可合并的普通线性层,还可以将 合并成一个权重矩阵,随后移除低秩分支。合并后如果仍然运行适配器,就会把同一更新加两次。量化模型的合并还涉及反量化和重新量化,不能把普通浮点权重的处理直接套过去。