
LoRA 减少了需要更新的参数,但基础模型依然占用大量内存。量化进一步追问:保存一个权重,是否一定需要 16 或 32 个 bit?如果允许可控的数值误差,就可以用更少的离散值表示它,减少存储和数据搬运。
代价在于,离散表示会改变计算结果,而且压缩格式必须得到实际算子支持。理解量化,既要知道一个数怎样被编码,也要知道误差怎样影响整层输出。
浮点精度与整数编码
浮点数由符号、指数和有效数字部分组成。指数影响可表示的数量级,有效数字影响给定数量级附近的分辨能力。FP16 和 BF16 都占 16 bit,却在指数范围与有效数字精度之间作了不同分配,因此“同样是 16 bit”不代表数值行为一样。
整数没有浮点数的指数结构。把 [0.1, 0.2, 0.9] 直接转换成整数,会把三个数都截成 0。量化并非简单类型转换,而是建立浮点值与整数编码之间的映射,再保存恢复数值所需的尺度信息。
scale 和 zero-point 如何工作
常见的仿射量化写作:
是 scale,决定相邻编码之间的间隔; 是 zero-point,让整数 对应实数 0;clip 把结果限制在编码范围内。量化得到 ,反量化得到近似值 ,一般不能恢复原来的全部信息。
采用对称量化时,可以让 ,范围围绕零展开。例如使用整数 [-127,127] 表示实数 [-1,1],则 。数值 对应编码 38,恢复后约为 0.2992。若使用非对称量化,可以针对偏向正值或负值的分布调整区间,提高编码范围的利用率,但需要处理零点偏移。
下面用普通 Python 演示对称映射。返回的整数列表只是编码示意,并没有真的把 Python 对象压缩成 8 bit:
def quantize_symmetric(values, bits=8):
    if bits < 2 or not values:
        raise ValueError("Use at least two bits and a nonempty input.")
    qmax = 2 ** (bits - 1) - 1
    peak = max(abs(x) for x in values)
    scale = peak / qmax if peak else 1.0
    codes = [max(-qmax, min(qmax, round(x / scale))) for x in values]
    restored = [code * scale for code in codes]
    return codes, scale, restored

codes, scale, restored = quantize_symmetric([-1.0, 0.0, 0.3, 1.0])
print(codes)     # [-127, 0, 38, 127]
print(restored)  # [-1.0, 0.0, 0.2992125984251969, 1.0]
全零输入单独处理,是为了避免 scale 变成零。这里假设输入有限;实际实现还要明确舍入规则、布局和异常值处理。
舍入与截断是两种不同误差
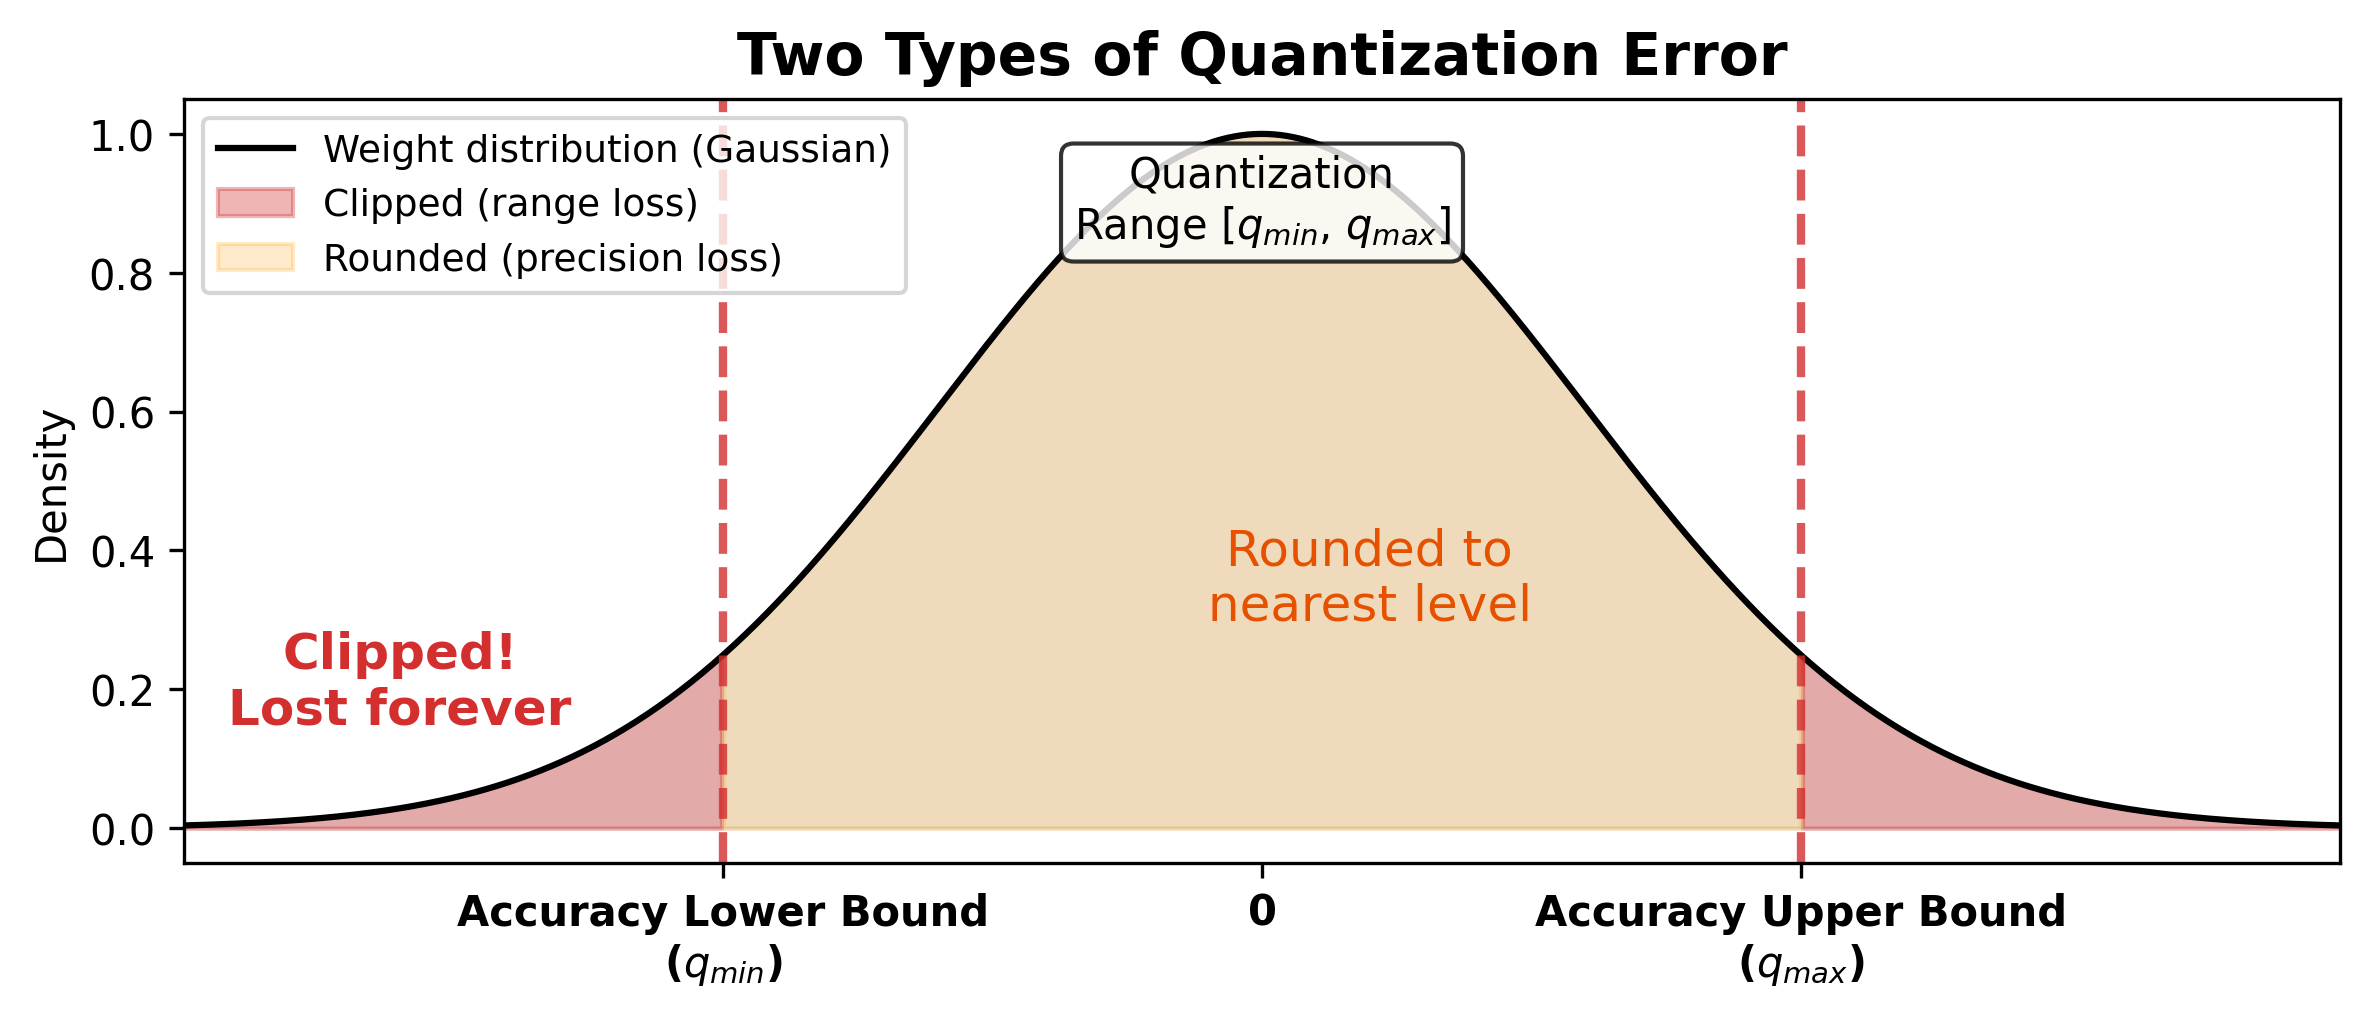
即使数值落在表示范围内,它也未必刚好位于离散网格上,取最近编码会带来舍入误差。若数值超过表示范围,就会被压到边界,产生截断误差。
扩大范围能容纳离群值,但在编码数量固定时,网格间距也随之增大,让大量常见数值的舍入误差变大。缩小范围能更细致地表达主要分布,却会牺牲两端。因此选择范围不是简单地“越大越好”,需要考虑最终输出误差。
为什么要分 channel、分 group
如果整个权重张量共用一个 scale,少数特别大的数可能决定所有权重的分辨率。把张量分成更小的区域,分别计算 scale,就能适应局部的数值分布。
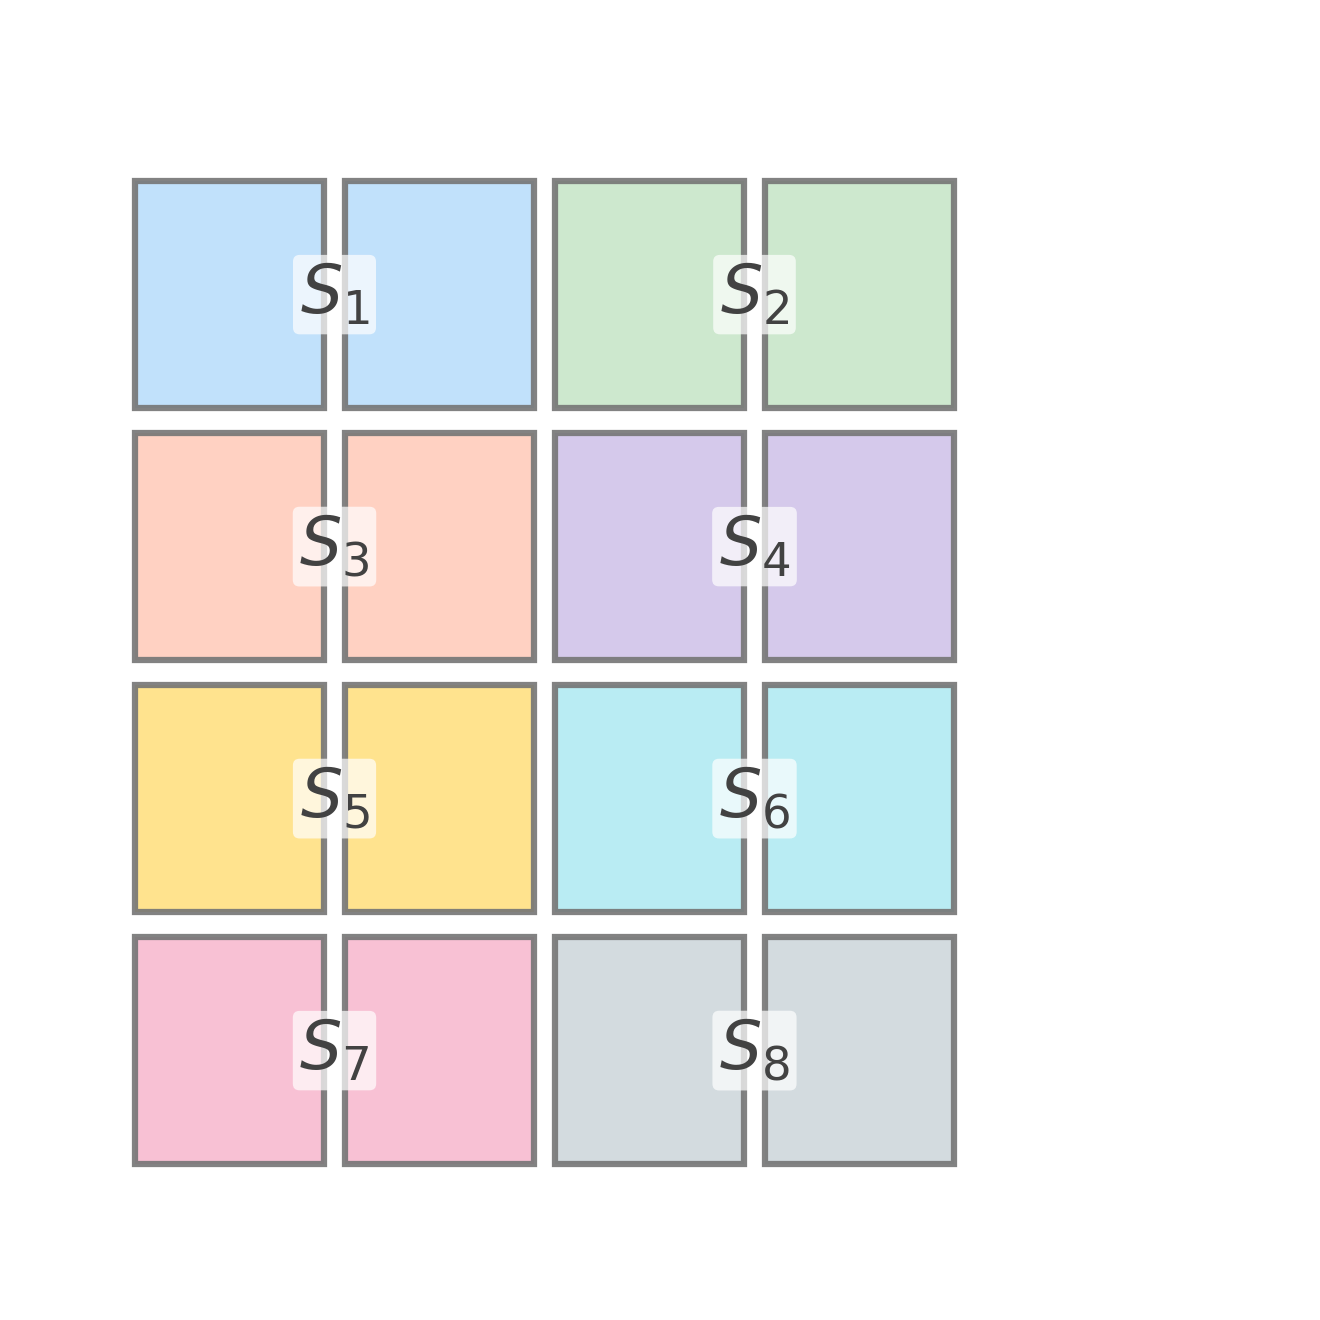
Per-tensor 为整个张量共享参数;per-channel 按某个指定轴分配参数;group-wise 则把指定维度上相邻的一组元素放在一起。这里的“channel”必须结合权重布局解释,不能只看矩阵的横竖方向。
分组越细,通常越容易控制误差,但需要保存更多 scale、zero-point,也可能增加内核处理成本。若每组有 个 4-bit 权重并附带一个 16-bit scale,仅这两项的平均存储就是 bit/权重;还有零点或其他元数据时要继续计入。所以模型标注“4-bit”,并不意味着每个参数连同附加信息恰好只占 4 bit。
PTQ:在训练完成后确定量化参数
Post-Training Quantization(PTQ)从已经训练好的模型出发,选择量化范围、尺度或补偿方式,然后导出适合推理的权重。需要激活统计的方法通常会先运行一小批校准数据;这些数据可以不带人工标签,但应覆盖目标使用场景、长度与输入格式。
还要区分量化对象。Weight-only 主要压缩权重,输入激活和累加可能仍使用较高精度;同时量化权重与激活,则对算子和数值稳定性提出更多要求。类似 W4A16 的记号描述这两个部分的位宽,并没有单独说明 scale 格式、分组大小或累加精度。
校准完成后,不能只看权重均方误差。对 ,量化误差 会产生:
某个权重的误差即使不大,若总与幅度很大的激活相乘,也可能显著影响输出。这正是激活分布值得参与权重量化决策的原因。
AWQ 为什么关注显著通道
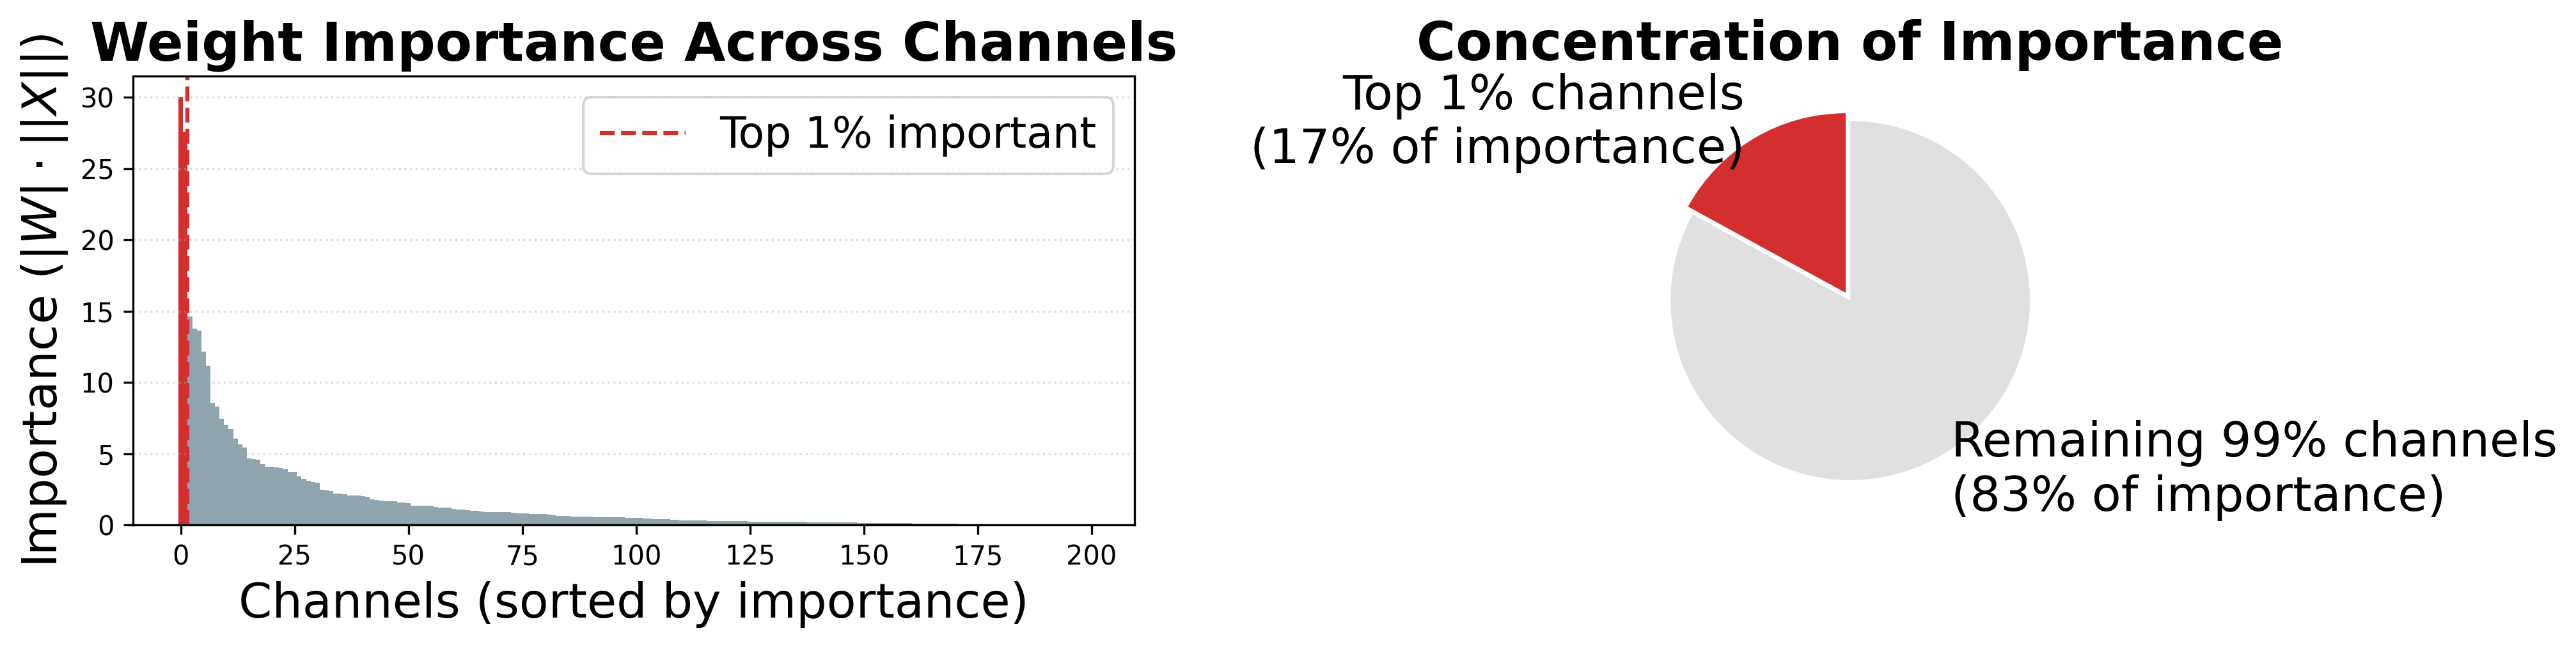
少量重要通道可能对误差特别敏感,但重要性不能只靠权重本身的绝对值判断。AWQ 使用校准输入的激活信息识别这种敏感性,并通过通道缩放改善低位宽权重量化。AWQ 论文讨论了这种方法及其推理实现。
仍使用 的列向量约定,取一个对角缩放矩阵 :
浮点运算中,这只是等价变换;但对 量化后,误差在乘回 时会发生变化。选择合适的通道尺度,可以给敏感通道更有利的量化条件,同时平衡其他通道的误差。
“保护重要权重”并不等于部署时必须把这部分权重逐个留成 FP16。图中的对比用于说明敏感性,AWQ 的缩放方法则把这种观察转化成适合低位宽权重的表示。它仍然会有量化误差,收益取决于模型、校准数据、位宽与分组设置。
QLoRA:低精度存储基础权重,高精度训练适配器
QLoRA 解决的是另一种需求:在较少显存下做微调。它把冻结的基础权重以低位宽形式保存,在计算时按需要反量化,同时训练较高精度的 LoRA 参数:
基础权重不更新,优化器主要维护适配器的状态。但梯度仍需要经过基础模型的运算传播,所以这并不是把整个基础模型从计算图中删掉。反量化也可以按块在算子内完成,不一定先永久生成一份完整浮点权重。
QLoRA 使用的 NF4 是一种非均匀 4-bit 编码:16 个编码对应一组预设代表值,再配合分组尺度。它针对近似正态的权重分布设计,让较密集的区域得到更细的表示;它既不是普通均匀 INT4,也不意味着所有模型都能无损量化。存储采用 NF4,不代表乘法、累加或适配器更新也都在 4 bit 下进行。QLoRA 论文给出了该表示及训练方法。
实际接入时,先用量化后端加载冻结基础模型,设置独立的计算 dtype,再进行低位宽训练准备、注入 LoRA,最后使用与普通 SFT 一致的样本和标签。训练准备包括冻结基础参数、按实现需要处理敏感层的精度和梯度路径。仅设置 load_in_4bit,还不能代替后续这些步骤。PEFT 的 量化训练说明展示了 BitsAndBytesConfig、prepare_model_for_kbit_training 与适配器注入之间的衔接。
从理论压缩率到实际收益
70 亿个权重按每个 4 bit 计算,纯编码约为 3.5 GB。运行时仍有尺度信息、未量化模块、激活、缓存和工作区;QLoRA 训练还包含适配器及其状态。因此这只是权重编码的估计,不是显存需求承诺。
量化也不保证更快。如果缺少匹配内核,反量化和布局转换可能抵消搬运量减少的收益。选择格式时,需要同时确认硬件、推理引擎或训练后端是否支持,并在实际 batch、序列长度和任务上测量质量、峰值显存、延迟与吞吐量。
若要比较普通 LoRA 与 QLoRA,保持数据、目标模块、训练预算和评测方式一致,才容易看清低精度基础权重带来的影响。若目标是部署 PTQ 模型,则更关心在可接受质量下降下,整个服务是否确实节省了资源。