
语言模型可以描述“查询天气,然后决定是否安排户外活动”,但描述本身不会发起查询。要让这句话变成实际流程,需要程序把模型的请求转换成工具调用,再把结果送回模型。模型选择下一步,宿主程序负责执行,这个分工是理解 Agent 的起点。
如果只是固定查一次资料再回答,可以直接写成工作流。若下一步取决于刚收到的结果,例如天气不适合户外时继续寻找室内地点,就需要一个能够根据观察调整行为的循环。
工具调用先是一种消息协议
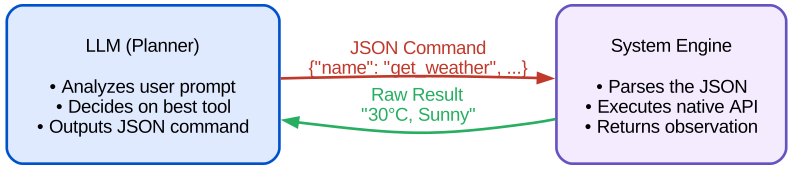
模型看到的是工具的说明,包括名称、用途和参数结构。假设提供一个天气查询工具,可以用 JSON Schema 描述其参数:
{
  "name": "get_weather",
  "description": "查询指定城市的天气,返回温度和天气状况。",
  "parameters": {
    "type": "object",
    "properties": {
      "city": {"type": "string", "description": "城市名称"}
    },
    "required": ["city"],
    "additionalProperties": false
  }
}
这份描述告诉模型如何请求工具,并没有把函数实现交给模型执行。工具实现仍然存在于宿主程序里,负责访问真实数据源、处理异常并返回结构化结果。
不同模型通过不同的 chat template 或 API 字段接收这些描述,生成的调用也可能采用不同格式。接入时需要解析成统一结构。例如本文约定一条请求包含 id、name 和对象形式的 arguments:
{
  "id": "call_1",
  "name": "get_weather",
  "arguments": {"city": "深圳"}
}
宿主程序执行后,返回带有同一个 tool_call_id 的结果。这个关联很重要:一轮可能有多个工具请求,不能只把结果拼成一段无法辨认来源的文本。
参数合法不等于任务已经完成
执行前,需要确认工具名在注册表里,参数满足类型和必填项约束,并通过该工具的业务检查。Schema 可以帮助约束输出,但宿主仍要验证实际收到的数据,不能把模型生成的字符串直接交给 eval。
执行成功后,也应返回足够解释结果的信息。例如天气的温度需要单位,文档检索需要来源,查询失败需要错误类型。模型随后依据观察决定继续调用还是给出答案,而不是把“发出了调用”误当成“已经得到了结果”。
一个最小的循环
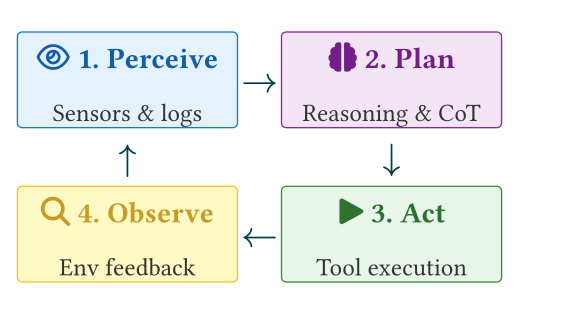
下面使用自定义的简化协议,展示模型与工具之间的控制流程。next_message(messages) 负责调用模型,并将响应规范化为 role、content、tool_calls;真实 API 的消息转换放在这个适配函数里。工具调用列表中的每个参数对象都已经完成 JSON 解码。
import json

def run_agent(question, next_message, tools, max_steps=6):
    messages = [{"role": "user", "content": question}]
    for _ in range(max_steps):
        reply = next_message(messages)
        messages.append(reply)
        calls = reply.get("tool_calls", [])
        if not calls:
            return {"status": "completed", "answer": reply.get("content", "")}
        for call in calls:
            try:
                if call["name"] not in tools:
                    raise ValueError("Unknown tool")
                arguments = call["arguments"]
                if not isinstance(arguments, dict):
                    raise TypeError("Tool arguments must be an object")
                result = tools[call["name"]](**arguments)
                observation = {"ok": True, "result": result}
            except (TypeError, ValueError) as error:
                observation = {"ok": False, "error": str(error)}
            messages.append({
                "role": "tool",
                "tool_call_id": call["id"],
                "content": json.dumps(observation, ensure_ascii=False),
            })
    return {"status": "step_limit", "answer": None}


def get_weather(city):
    if not isinstance(city, str) or not city.strip():
        raise ValueError("city must be a nonempty string")
    return {"city": city, "temperature_c": 29, "condition": "rain", "mock": True}


def demo_model(messages):
    if messages[-1]["role"] == "user":
        return {
            "role": "assistant", "content": "",
            "tool_calls": [{
                "id": "weather_1", "name": "get_weather",
                "arguments": {"city": "深圳"},
            }],
        }
    observation = json.loads(messages[-1]["content"])
    result = observation["result"]
    return {
        "role": "assistant",
        "content": f"演示天气为 {result['temperature_c']}°C,有雨,建议安排室内活动。",
        "tool_calls": [],
    }

result = run_agent("深圳适合户外活动吗?", demo_model, {"get_weather": get_weather})
print(result)
这个例子可以离线运行:demo_model 是确定性替身,天气也是模拟数据,用来观察“请求—执行—结果—回答”的顺序。替换为真实模型时,适配函数还需注入工具定义、验证响应结构及调用 ID,再把历史中的工具结果转换回相应 API 协议。
代码只展示已知参数错误的反馈路径。实际工具应把可恢复的网络超时、检索失败等转成明确的观察;无法恢复的程序错误可以终止任务并由宿主记录。max_steps 限制模型轮数,生产系统还需要限制单轮调用数量、总耗时和单工具超时。达到上限时返回独立状态,避免把中途停止当成成功回答。
从一次调用到有条件的计划
假设用户要求:“先看天气,适合户外就查公园,否则查室内展馆,并告诉我开放时间。”这项任务中的地点查询依赖天气结果,不能在一开始就假设应走哪条分支。
| 步骤 | 已获得的信息 | 下一步 |
|---|---|---|
| 1 | 用户希望根据天气安排活动 | 查询天气 |
| 2 | 天气结果显示下雨 | 查询室内展馆 |
| 3 | 检索到候选地点,但开放时间缺失 | 查询该地点的开放时间 |
| 4 | 已有适用地点和时间证据 | 汇总回答并标明来源 |
这就是交替决策、行动和观察的基本形式。ReAct将推理与外部行动结合,使后续决策能够利用工具反馈。工程日志可以记录选择了什么工具、使用了哪些参数、观察到了什么,以及为什么切换分支的简短说明;理解和排查流程不需要依赖模型完整的内部思维过程。
计划也可以先分解为几个子任务,再根据新信息调整。若两个查询互不依赖,可以并行;若第二步依赖第一步的返回值,就应保持顺序。调用更多工具本身并不代表更聪明,合适的终止条件同样属于计划的一部分。
反馈怎样支持自我修正
假设一个计算工具返回错误:Python 列表没有 .mean() 方法。模型可以依据这个错误改用 sum(values) / len(values),并确认列表不为空,再重新提交计算。有效修正依赖明确的失败信息,而不是重复发送同一条请求。
对外部操作还需要区分“执行失败”和“结果未知”。例如请求超时,可能只是没有收到响应,不能据此断言操作从未发生。是否重试、如何检查状态、是否需要幂等键,应由工具契约和宿主控制逻辑决定。模型能够提出下一步,但执行权限仍由应用掌握。
记忆保存什么,遗忘什么
短期记忆通常就是本次任务的消息、工具结果、当前计划和中间状态。它让模型知道哪些步骤已经完成,但持续堆积完整日志会占满上下文。可以保留关键原始结果,并对较早过程做摘要,明确区分已观察事实、用户要求和仍待验证的假设。
长期记忆保存跨任务有用的信息,例如用户明确的偏好或已确认的文档事实。它可以用结构化数据库,也可以像 RAG 一样通过检索取回。来源、时间和适用范围需要一起保留,否则旧观察会在未来被当成永远有效的事实。
从系统组成看,模型负责理解与决策,工具连接外部环境,记忆保存状态,计划组织步骤;反馈使这些部分构成循环。任一部分设计不清楚,都可能表现为模型“忘记做过的事”或反复尝试已经失败的动作。
框架解决的是状态与调度问题
LangChain 提供模型、消息和工具等组件的抽象;LangGraph 则把工作流表达为带状态的图,用节点描述计算,用边描述下一步选择,并支持持久化执行等能力。两者的职责与配合方式可以参阅 LangGraph 文档。
对于刚才的循环,可以把模型调用、工具执行和结束条件表示成不同节点:模型输出工具请求时进入工具节点,工具完成后回到模型节点,没有请求时结束。这样更容易检查状态、恢复中断任务,也能把必须固定执行的步骤与模型决定的步骤放在同一流程里。
评估 Agent 时,除了最终答案,还应检查是否调用了正确工具、参数是否正确、是否遵守依赖顺序、遇到错误能否恢复,以及完成任务需要多少轮和成本。把这些过程指标与最终成功率一起看,才能区分模型能力、工具质量和控制程序各自的问题。