
语言模型的输入原本是一串 token,而图片是一张二维像素网格。视觉语言模型(Vision-Language Model,VLM)需要先把像素变成能够表达内容和空间关系的特征,再让这些特征与文字一起参与计算。
以“图中红色按钮在哪里”为例,模型既要识别按钮,也要把文字中的颜色和对象对应到图像区域,最后输出位置。这个过程可以沿着一条清楚的路径理解:图片张量、局部 patch、视觉编码器、跨模态连接、语言输出。
图片进入模型前经历了什么
一张 RGB 图片可以表示为形状 (H,W,3) 的数组,三个通道分别保存红、绿、蓝信息。神经网络中常用 (B,C,H,W) 布局,其中 是 batch 大小,。
从 (H,W,C) 变为 (C,H,W) 是维度置换,应使用 transpose 或 permute,不能只改变 reshape 的目标形状。前者改变维度对应关系,后者可能把不同像素和颜色分量混在一起。
输入通常还会经历缩放、裁剪、转成浮点数、归一化等步骤。归一化的均值与方差应与预训练模型匹配,不能只凭经验换一组数字。文字和图片的预处理常由同一个 processor 协调,确保视觉张量、图片占位符和其他元数据对应。
对分类任务,图像变换主要影响识别效果;对定位任务,它还改变坐标系。因此原图大小、缩放比例、裁剪偏移和 padding 必须保留,后面才能把预测位置映射回原图。
Patchify:把二维网格变成序列
Vision Transformer(ViT)把图片划分成大小为 的小块。若图片高宽都能被 整除,patch 数量是:
每块包含 个像素通道值,展平后再通过线性投影,得到 维的向量。这样,一张图片就成为长度为 的视觉序列。
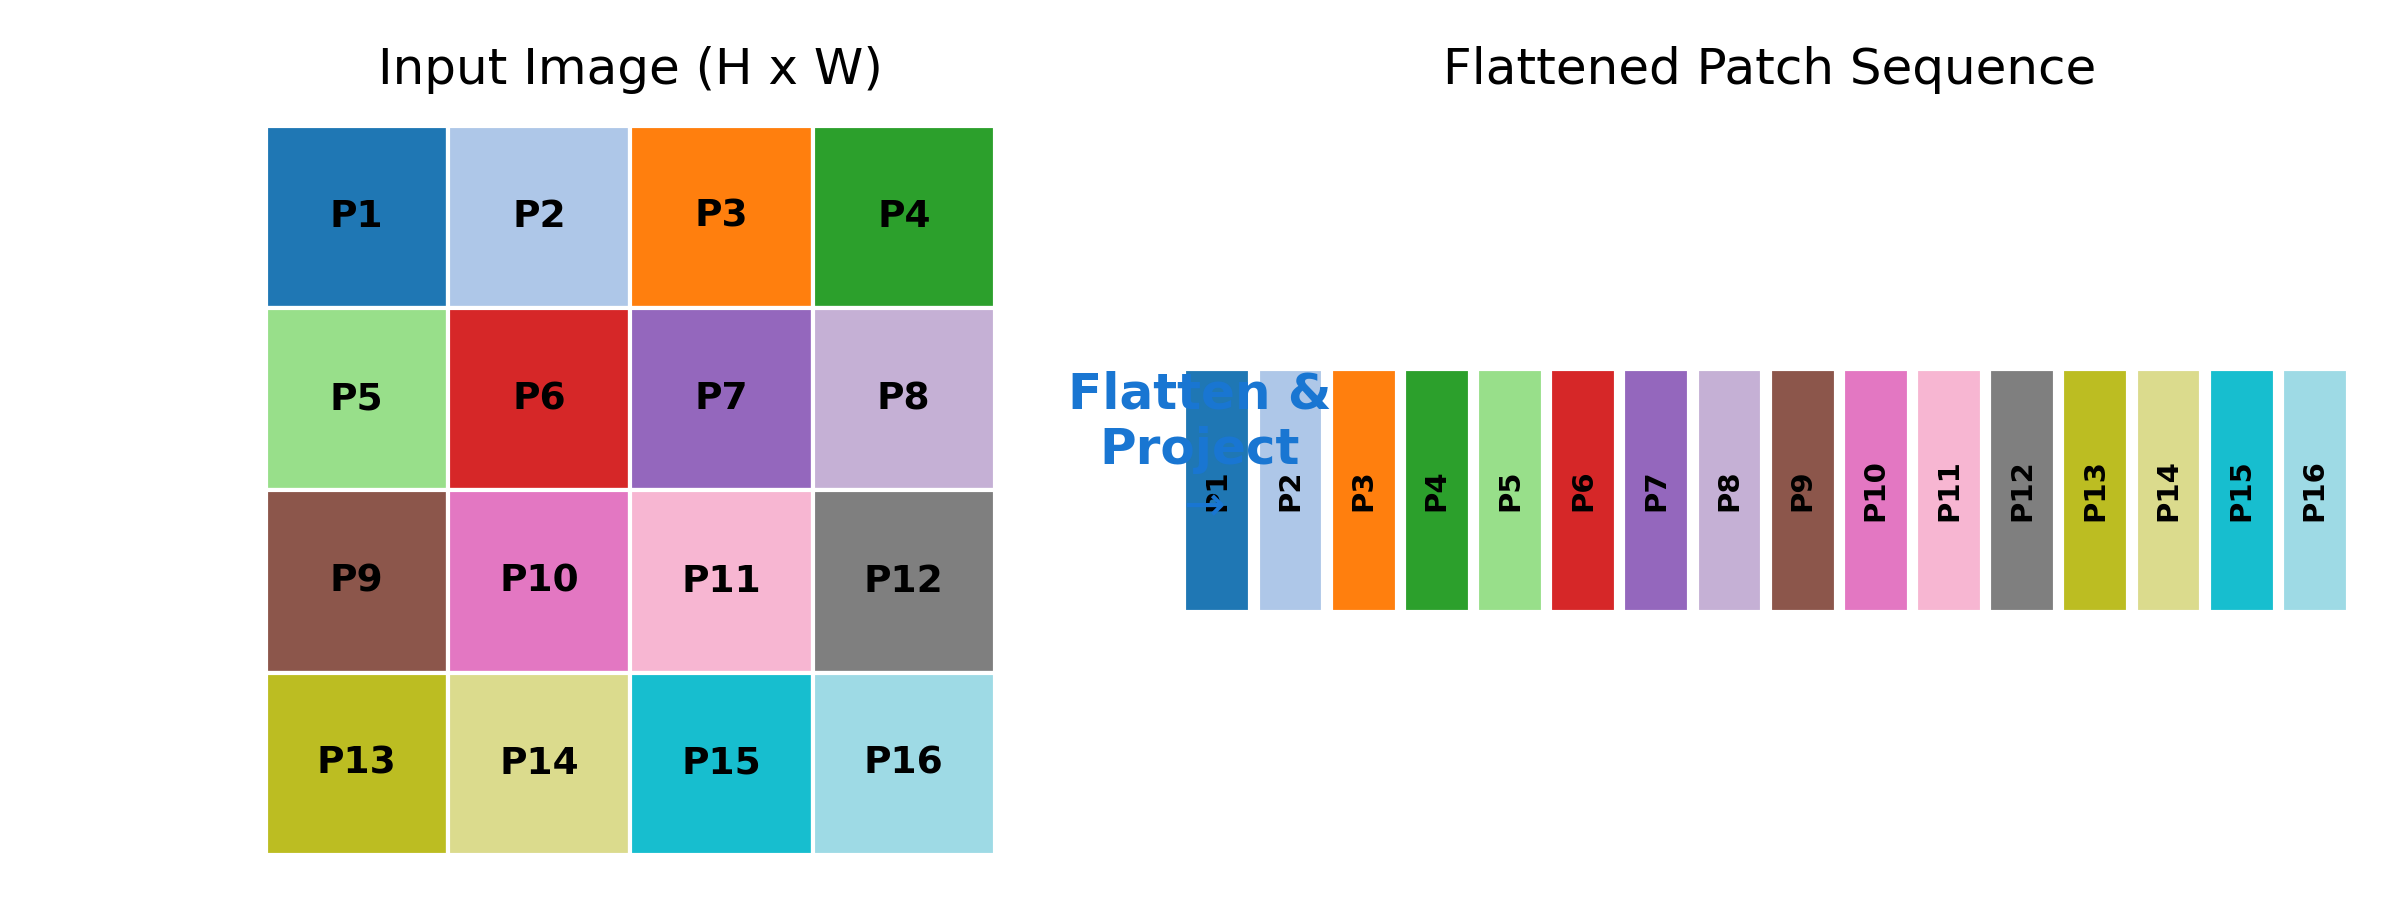
例如 RGB 图片为 ,patch 边长为 16,则得到 个 patch,每个 patch 展平后有 个数。下面显式完成分块与投影:
import torch
from torch import nn

images = torch.randn(2, 3, 224, 224)
B, C, H, W = images.shape
P, D = 16, 512
assert H % P == 0 and W % P == 0

patches = images.reshape(B, C, H // P, P, W // P, P)
patches = patches.permute(0, 2, 4, 1, 3, 5)
patches = patches.reshape(B, (H // P) * (W // P), C * P * P)
projection = nn.Linear(C * P * P, D)
tokens = projection(patches)
print(tokens.shape)  # torch.Size([2, 196, 512])
第一次 reshape 把高、宽拆成“块索引”和“块内坐标”;permute 把两个块索引放到前面,确保最后展平的是同一个 patch 内的像素。这一步如果顺序写错,输出形状可能仍然正确,但局部图像结构已经被打乱。实际实现也可以用 kernel 和 stride 都为 的卷积完成类似投影。
ViT 让局部特征获得全图上下文
刚投影出来的 patch token 只描述局部像素。加上位置表示,再经过多个 Transformer encoder block,patch 才能通过 self-attention 与其他区域交换信息,理解局部纹理属于哪个物体、它与周围内容有什么关系。
用于图像分类的 ViT 可以引入一个分类 token,从最后的表示预测整张图片的类别。VLM 经常需要保留多个空间位置的视觉特征,而不是只取一个全局类别向量,因为文字可能询问某个小物体、局部文字或相对位置。ViT 论文给出了将图片作为 patch 序列处理的基本方法。
这里已经能复用 Transformer 的知识:注意力混合位置之间的信息,FFN 变换每个位置的特征,残差和归一化支持深层网络。区别主要在于输入表示和空间位置,而不是重新发明一套完全不同的计算规则。
Projector 连接视觉与语言表示
视觉编码器输出的维度 可能与语言模型的隐藏维度 不同。Projector 首先解决维度连接问题,例如对每个视觉 token 使用线性映射:
但维度一致只是必要条件。未经训练的投影不能自动让语言模型理解图像,跨模态训练还需要让这些向量进入一个语言模型能够利用的表示空间。
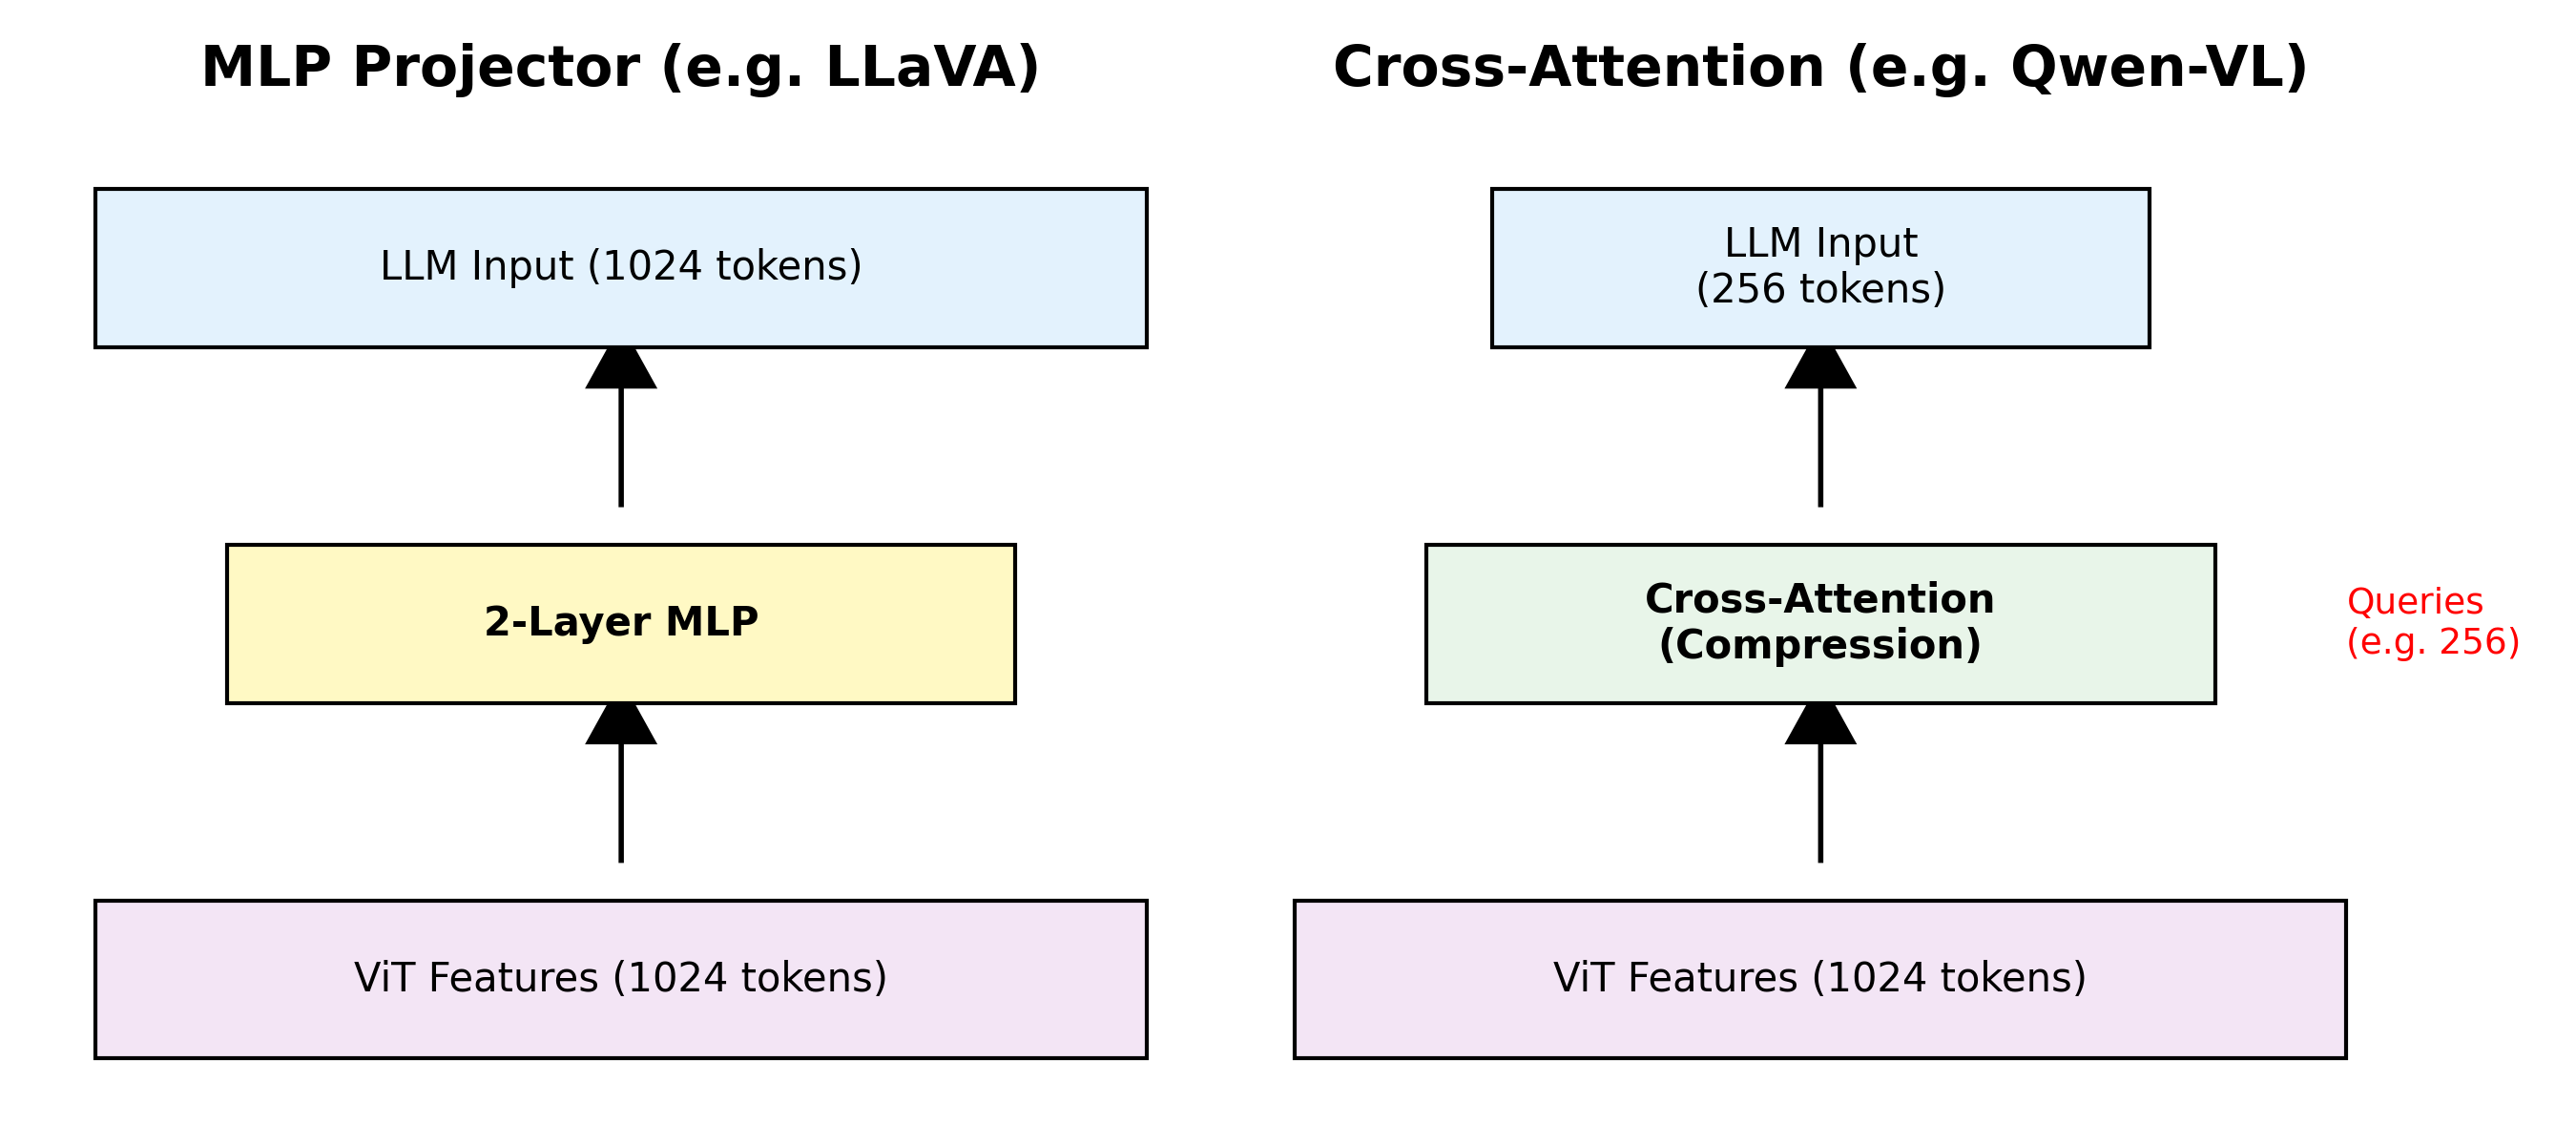
线性 projector 成本低,通常保留 token 数量;MLP 增加非线性变换,但也不必然缩短序列。基于查询的连接模块或 resampler 可以用较少的查询从视觉序列中读取信息,将可变长度特征压缩为受控数量的 token。这能减少后续语言模型的负担,但压缩过强可能损失小字和局部细节。
一种常见的 VLM 结构把投影后的视觉 token 插入文字序列中的相应位置,然后交给语言模型处理;也有架构通过专门的 cross-attention 读取视觉特征。理解具体模型时,应确认它采用哪种连接方式,以及视觉 token 数量如何影响上下文长度。
为什么高分辨率不能只靠统一缩小
把所有图片缩成固定的小尺寸,容易丢失文档小字和远处物体。增加分辨率能保留细节,却也增加 patch 数量:高、宽同时翻倍,在 patch 大小不变时,视觉 token 数量会变成四倍。
处理高分辨率有不同路线。一种方法保留全局缩略图,再把原图切成多个局部块,分别编码后组合。另一种方法支持随图片尺寸变化的视觉 token 序列,并控制允许的像素预算。两种方法都在分配全局信息、局部细节与计算成本,但不能把它们当成同一种实现。
例如 Qwen2-VL采用原生动态分辨率,让不同分辨率对应不同数量的视觉 token,并使用多模态位置编码。分析其输入时,应遵循该模型 processor 的实际缩放、patch 和合并规则,而不是直接套用“缩略图加固定数量裁片”的公式。
一维序号怎样表达二维位置
如果按行展开 patch,一维索引相邻通常表示水平相邻,但一行最后一个 patch 与下一行第一个 patch 也会相邻。图片宽度改变时,同样的垂直邻居在一维索引中的距离也会改变。只保留序列顺序,不容易直接表达稳定的二维关系。
二维位置表示为 patch 提供行、列坐标;多模态 RoPE 进一步让不同通道组使用不同的位置轴。以 Qwen2-VL 的 M-RoPE 为例,位置涉及时间、高度、宽度:文字使用与序列位置一致的坐标,静态图片的时间坐标固定而空间坐标变化,视频则还包含时间上的变化。
这些坐标参与 Q、K 的旋转,使注意力能够利用相对位置关系。它为模型提供空间结构,并不意味着“有了位置编码就必然能准确定位”;识别对象和将语言与对象关联仍需要训练。
怎样训练视觉与语言之间的连接
一种常见训练安排先固定已有视觉编码器和语言模型,训练连接模块,使视觉特征能够被语言模型使用;随后在更丰富的多模态指令数据上训练连接模块,并按设计解冻部分或全部网络。不同模型的阶段、数据和冻结策略不同,这不是所有 VLM 都必须遵循的固定配方。
样本可以是图片描述、OCR、视觉问答或定位任务。例如输入一张设备面板图和问题“红色按钮上写着什么”,目标是正确的文字回答。对生成式模型,训练仍然可以使用下一 token 交叉熵:图像和用户问题提供条件,损失主要放在 assistant 的目标回答上。
冻结语言模型的权重不代表可以随意对它使用 no_grad():当连接模块需要学习时,梯度还要经过语言模型的计算回到连接模块。是否保存某段计算图,取决于上游是否存在需要更新的参数,这与 LoRA 中的梯度路径是同一个问题。
多模态消息需要同时携带文字与图片
视觉问答的 user 消息通常包含多个内容块,例如“这是什么?”的文本块和一张图片。图片可能通过本地对象、字节数据或 URL 传入,具体取决于处理器和服务接口;仅在普通文本里写一个图片路径,不一定会触发视觉处理。
处理器需要保证图片顺序与消息中的占位符一致。多张图片或多轮对话中,如果只保留了文字历史,却漏掉仍被问题引用的图片,模型就可能失去必要上下文。生成时通常也只解码新增的文字输出,而不是把整个输入序列重复显示出来。
评估视觉问答时,应检查回答是否真的依据图片。例如把图片替换为另一张相似面板后,答案是否随视觉证据改变;对于 OCR,则需要比较识别文本,而不只是判断回答是否流畅。
Grounding:把描述对应到图像区域
Grounding 要把“左侧红色按钮”这样的描述转换成点或边界框。边界框常写成 ,但坐标原点、数值范围、端点约定都属于模型协议,必须明确。
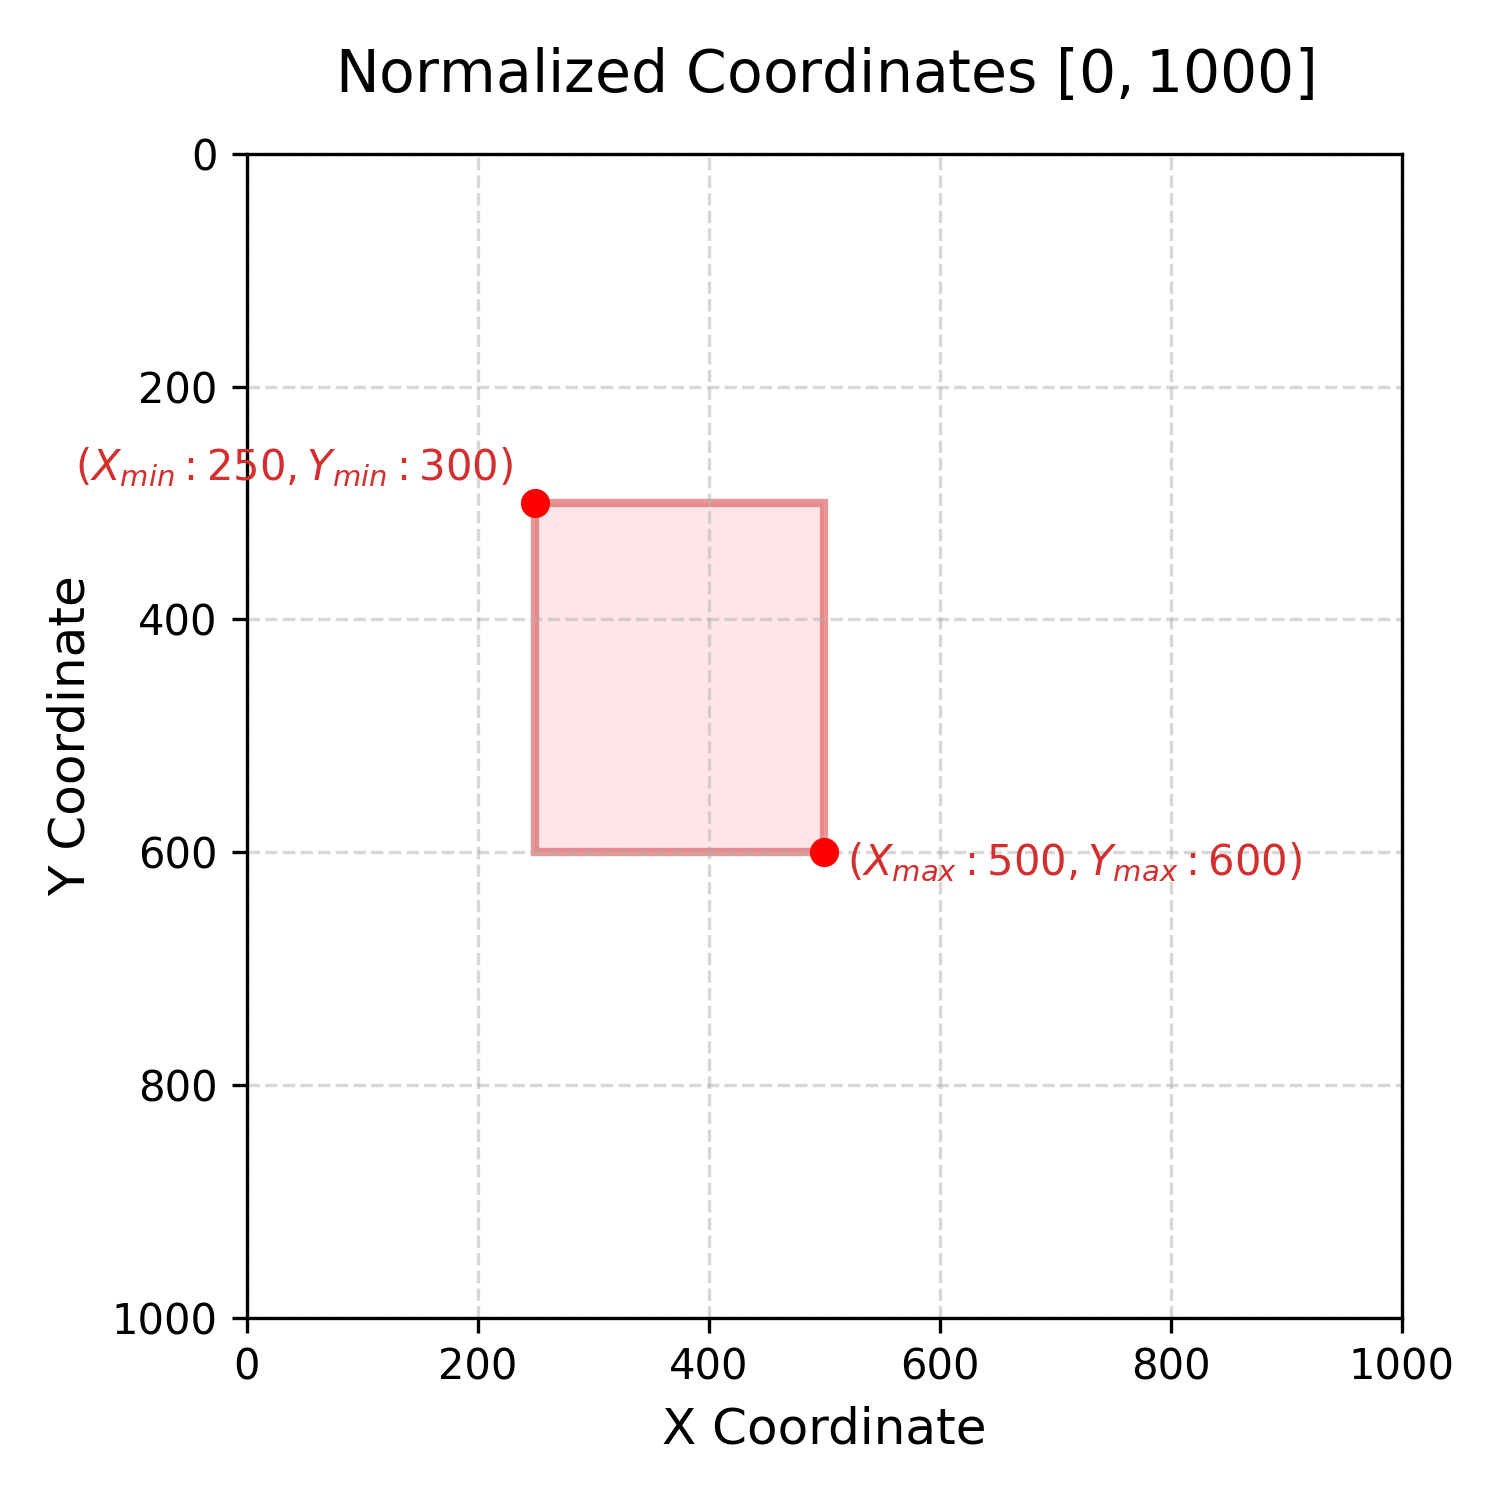
有些模型使用 0 到 1000 的归一化坐标。采用以图像宽高为分母的连续坐标约定时:
例如在宽 1280、高 720 的图片中,点 对应 ;恢复时分别乘以 和 。这个范围不是所有 VLM 的统一标准,有的模型直接输出像素坐标,有的使用 0 到 1;数字也不一定各自对应单独一个 token。
若模型输出的是预处理后图片的坐标,还需要撤销预处理。假设原图先以比例 缩放,再在左侧和上侧分别补 ,则:
如果中间还发生裁剪,就要按变换顺序恢复裁剪偏移。最终应将框限制在有效图像范围内,并检查两个角点的顺序。坐标映射错误会让一个本来正确的模型预测看起来像识别失败。
定位可以使用交并比 衡量,但还要确认框到的是用户所指的对象。视觉理解、语言指代和坐标变换分别承担不同职责,逐段检查这条路径,比只看最终生成的一串数字更容易找出问题。